The Engine We Lost: Digital Archaeology of Opera Presto
Движок, который обогнал Chrome: полный ES2015 и новый медиабэкенд
Оглавление
- XXII. Шаг назад, два шага вперёд
- XXIII. Проигрыватель, который ничего не проигрывает
- XXIV. Замена проигрывателя на выигрыватель
- XXV. Что дальше?
На прошлой неделе похвастаться было как будто бы нечем, а сегодня я без всякого жеманства показываю вам вот это:
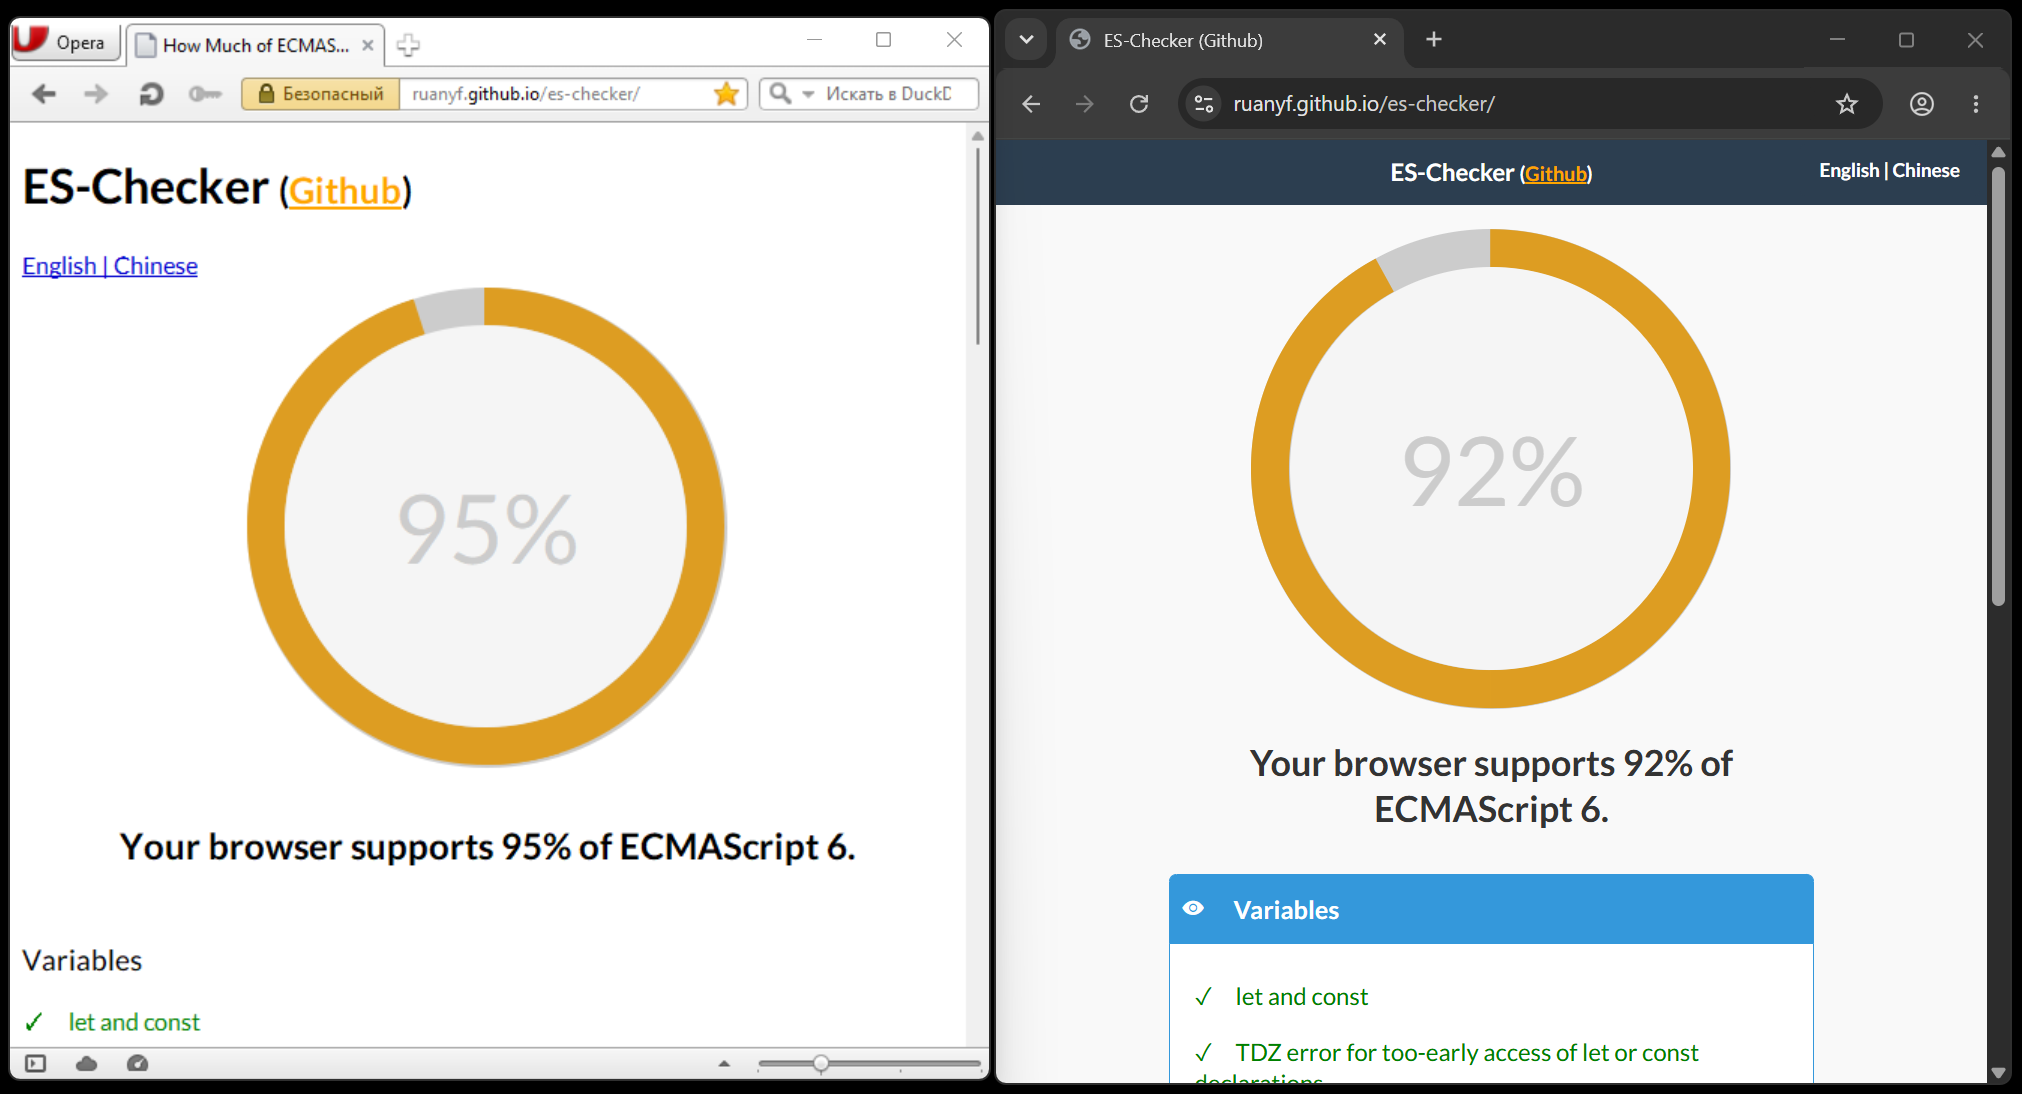
Слева — актуальный билд Оперы. Справа — свежайший Chrome.
И это ещё не всё.
Присаживайтесь. Погружение будет долгим.
XXII. Шаг назад, два шага вперёд
Я уже рассказывал, что Carakan получил поддержку ES2015 за неделю. Это было одновременно правдой и очень большим упрощением.
Движок действительно научился разбирать и исполнять стрелочные функции, классы, модули, генераторы, деструктуризацию и прочие конструкции, о которые прежде разбивался современный скрипт. Появились Symbol, коллекции и Promise, сверху добавился async/await, нужный для тестов. Главный практический барьер был снят: Carakan перестал считать современный JavaScript синтаксической ошибкой.
Но между пониманием и полноправной реализацией лежат тысячи мелких правил о том, в каком порядке вычисляются выражения, из какого глобального объекта берётся прототип ошибки, сколько раз можно прочитать свойство, что происходит при нехватке памяти и обязан ли рекурсивный вызов когда-нибудь переполнить стек. Это, собственно, и есть язык.
Поэтому после первого штурма пришлось вернуться и проделать всю работу ещё раз — теперь не по списку возможностей, а по спецификации целиком. И вот здесь история Carakan стала гораздо интереснее.
XXII.I JS-машина из 2009 года
Carakan проектировался в очень конкретный момент истории. Предыдущий движок Opera назывался Futhark и был прежде всего компактным: это разумный приоритет для браузера, который должен работать на телевизорах, карманных компьютерах и телефонах, где память измерялась десятками мегабайт. Но к концу 2000-х веб-страницы начали превращаться в приложения, Google и Apple устроили гонку JavaScript-производительности, а экономить несколько мегабайт ценой медленного исполнения стало невыгодно.
В феврале 2009 года Opera рассказала о новом движке, построенном вокруг трёх идей: регистрового байткода, генерации машинного кода и автоматической классификации объектов. В Opera 10.50 он пришёл на смену Futhark.
Первая идея понятнее всего на маленьком примере. Стековая виртуальная машина складывает две переменные примерно так:
положить a на стек
положить b на стек
сложить два верхних значения
снять результат в c
Регистровая — так:
сложить r1 и r2, результат записать в r3
Её инструкция длиннее, зато не приходится постоянно перекладывать данные на вершину стека и обратно. Исполняется меньше команд, копируется меньше значений, а промежуточное представление больше похоже на то, с чем затем работает настоящий процессор.
Компилятор Carakan превращает исходный JavaScript в такой байткод, а дальше один и тот же поток инструкций может либо исполняться интерпретатором, либо переводиться в машинный код. Внутренняя документация называет байткод API между компилятором и JIT. Это хорошая граница: сложный парсер не обязан знать, на каком процессоре работает Opera, а сложный генератор машинного кода не обязан заново понимать JavaScript.
Поверх общей части стоят нативные бэкенды x86, x86-64, ARM и MIPS. Они не используют ни LLVM, ни внешний ассемблер — Carakan сам кодирует машинные инструкции, сам распределяет регистры и сам строит переходы между C++, интерпретатором и сгенерированным кодом. Регулярные выражения обслуживает отдельный компилятор, у которого есть собственный JIT под те же архитектуры.
Даже стандартная библиотека отделена от машины необычным способом: значительная часть встроенных функций написана на самом ECMAScript и при сборке компилируется в тот же байткод. Горячие операции, тесно связанные с внутренностями, реализованы на C++, но для остального язык служит собственной библиотечной платформой. Это ещё одна причина, почему расширять существующий байткод оказалось полезнее, чем строить рядом второй интерпретатор.
Вторая половина конструкции — модель объектов. JavaScript разрешает добавить объекту любое свойство в любой момент, удалить его, заменить число строкой и подменить прототип. Наивная реализация хранит рядом с каждым объектом тяжёлую таблицу, объясняющую, что именно в нём сейчас лежит. Carakan вместо этого объединяет похожие объекты внутренними классами: если тысяча объектов получила одинаковые свойства в одинаковом порядке, описание формы хранится один раз, а каждый объект ссылается на него.
Документация «Compact Object Model» рассказывает об этом подробно: старая форма объекта требовала в разных случаях шесть, семь или как минимум четыре указателя. Новая сводила всё к одному — указателю на класс. Сам класс знает имена свойств, их типы и физические смещения; объект хранит значения прямо в отведённых местах. На 32-битных платформах значения дополнительно упаковываются в восемь байт с помощью NaN-boxing: некоторые комбинации битов числа NaN используются как метки целых чисел и указателей.
Почему всё было сделано именно так? Потому что Carakan одновременно требовались скорость настольного браузера, экономность встраиваемого устройства и переносимость между процессорами, для которых не существовало общей современной инфраструктуры. Он должен был переживать нехватку памяти, собираться без STL и исключений, работать в том же однопоточном цикле сообщений, что и сеть, DOM и раскладка страницы. Переход от ориентированного на экономию Futhark к ориентированному на скорость Carakan не отменил оперовскую привычку считать каждый указатель.
Это важно для дальнейшей истории. Обновлять пришлось не абстрактную реализацию JavaScript, а очень плотный механизм, где свойства объекта, байткод, сборщик мусора и четыре генератора машинного кода знают друг о друге гораздо больше, чем хотелось бы человеку, впервые открывшему исходники.
XXII.II ES6 — это вам не стрелочки
Самой лёгкой частью обновления, как ни странно, оказался новый синтаксис. «Лёгкой» — не в смысле «простой», но хотя бы «имеющей понятное место в архитектуре».
Лексер получает новые токены, парсер — новые узлы, компилятор — несколько способов разложить их на существующий или дополненный байткод. Так появились двоичные и восьмеричные литералы, шаблонные строки, краткая запись свойств, параметры по умолчанию, rest и spread. Даже классы в конечном счёте — очень сложный способ создать функции и объекты-прототипы; большая часть необходимой машинерии для них уже существовала.
Там, где JIT не умел выразить новую конструкцию, использовался предусмотренный авторами путь отхода: функция оставалась в интерпретаторе. Так работают генераторы, которым нужно остановиться на yield, сохранить свой регистровый кадр и продолжить позже. Так же исполняются async-функции, обращения к new.target, некоторые функции со сложными параметрами и, как выяснится ниже, правильные хвостовые вызовы. Старый JIT не переписывался целиком ради новой возможности, но и весь движок не лишался ускорения.
С регулярными выражениями был отдельный соблазн: выкинуть их компилятор и подключить внешнюю современную библиотеку. Это выглядело разумно ровно до чтения спецификации: JavaScript-регулярки требуют отдавать наружу lastIndex, флаги, захваты, свойства конструктора и порядок вызовов; уметь подменять методы через Symbol и взаимодействовать со строковыми функциями. PCRE или RE2 принесли бы совершенно другую семантику. Поэтому родной компилятор регулярных выражений (включая его безумный отдельный JIT) остался на месте — его научили флагам u и y, новым правилам сопоставления и протоколам Symbol.match, Symbol.replace, Symbol.search и Symbol.split.
Но затем закончились конструкции, которые можно «просто добавить», и начались правила, которые заставляют переделывать старые.
Возьмём обычное присваивание:
object[key()] = value();
Спецификация требует сначала вычислить object, затем ровно один раз вызвать key(), сохранить получившуюся ссылку на место назначения, и только после этого вызвать value(). Этому есть причины: value() может удалить свойство, заменить прототип, отозвать Proxy, запустить сборщик мусора или вообще уничтожить окружение, в котором найдено имя. Если после правой части заново поискать объект или вычислить ключ, получится другая программа.
Старый компилятор во многих местах хранил не ссылку, а способ найти её позже. Для ES5.1 этого почти всегда хватало; ES2015 сделал порядок наблюдаемым гораздо чаще. Пришлось учить байткод заранее фиксировать базу, ключ и лексическое окружение, держать их в корневых регистрах во время произвольного пользовательского кода, а затем совершать запись именно туда, куда указывало исходное выражение.
Та же история повторилась с delete, деструктуризацией, значениями параметров по умолчанию, eval, with, super, итераторами и конструкторами. Возможно, самая сложная часть ES2015 — в том, что между двумя уже существовавшими действиями стандарт теперь определяет третье.
Отдельным слоем лежит асинхронность. Promise потребовал общей очереди микрозадач, согласованной с DOM и циклом сообщений браузера. Модулям понадобились не только import и export в парсере, но и загрузка графа файлов, CORS, жизненный цикл <script type="module"> и правильная доставка ошибок. Генераторы и async/await потребовали приостанавливаемых регистровых кадров.
При этом основа не была заменена. Парсер остался парсером Carakan, байткод — его байткодом, объекты — его компактными объектами, сборщик мусора — его сборщиком, а обработка нехватки памяти по-прежнему возвращает OP_STATUS или проходит через LEAVE/TRAP. Новая семантика встраивалась в старые органы, а не пересаживалась вместе с чужим движком.
XXII.III Объекты, которым нельзя доверять
Если выбирать одну возможность ES2015, способную испортить настроение автору любого JavaScript-движка, то это Proxy.
Обычный объект в Carakan предсказуем. Если внутренний класс говорит, что x находится по смещению 24, JIT может проверить класс и прочитать память по смещению 24. На этом держится вся производительность объектной модели.
Proxy превращает почти любое действие над объектом в вызов пользовательского JavaScript:
const p = new Proxy(target, {
    get(object, name, receiver) {
        console.log(name);
        return Reflect.get(object, name, receiver);
    }
});
Теперь чтение p.x может вывести текст, изменить target, вызвать другой Proxy, собрать мусор, выбросить исключение или отозвать сам p. То же относится к записи, удалению, проверке in, получению прототипа, перечислению ключей, вызову функции и работе new. Оптимизация «мы уже знаем, что здесь лежит» становится ошибочной.
Одних перехватчиков недостаточно. Стандарт охраняет инварианты настоящего объекта. Proxy не имеет права сообщить, что несуществующее свойство ненастраиваемо, скрыть ненастраиваемое свойство при перечислении, выдать другой прототип у нерасширяемого объекта или вернуть примитив из конструктора. Значит, после произвольного вызова обработчика движок обязан снова проверить цель — хотя за время вызова она могла измениться.
Работа была разделена на три слоя. Сначала появился внутренний exotic object с возможностью отзыва, консервативным запретом старых кешей и состоянием, закреплённым для сборщика мусора. Затем через него провели одиннадцать групп операций над свойствами, прототипом, расширяемостью и ключами. И лишь в конце открыли публичный Proxy, вызовы, конструирование и Proxy.revocable. До этого конструктор намеренно оставался скрыт: частичный Proxy хуже отсутствующего, потому что выглядит рабочим и ломает инварианты в тех местах, до которых ещё не добрались.
Особенно неприятными оказались функции-Proxy. В нативных бэкендах Carakan есть быстрые пути для известных встроенных функций — например, специальная identity Function.prototype.apply. Callable Proxy нельзя спутать с такой функцией, даже если он её оборачивает: сначала должен отработать trap. Защиту пришлось добавить во все соответствующие быстрые пути x86, ARM и MIPS.
XXII.IV Как убить вызывающую функцию и ничего не сломать
Самой трудной отдельной возможностью оказались не классы, не модули и даже не Proxy. Ей стали proper tail calls — правильные хвостовые вызовы.
В строгой функции вызов находится в хвостовой позиции, если его результат сразу становится результатом самой функции:
"use strict";

function contains(node, value) {
    if (!node)
        return false;
    if (node.value === value)
        return true;
    return contains(node.next, value);
}
Обычный вызов добавляет в стек новый кадр: локальные переменные, аргументы, адрес возврата. Сто тысяч элементов списка дадут сто тысяч кадров и закончатся переполнением. ECMAScript 2015 требует, чтобы хвостовой вызов не сохранял кадр вызывающей функции.
Требование настолько неудобное, что его реализация в WebKit заслужила отдельную статью и отдельный механизм отладки ShadowChicken, а другие движки годами предпочитали с ним не связываться. Но Opera всегда славилась полнотой поддержки стандартов, так что варианта игнорировать требование у нас не было.
Сначала компилятор научился отмечать хвостовые позиции. Они не сводятся к текстовому поиску return f(): вызов может прятаться в одной из ветвей условного выражения, в логической операции или после запятой, но не должен появляться внутри генератора или там, где результат ещё нужно обработать.
Затем интерпретатор научился не добавлять новый кадр, а заменять текущий. Звучит просто: раз вызывающая функция больше не нужна, освободим её регистры и запустим следующую. Но перед уничтожением кадра могут понадобиться его аргументы; замыкание может удерживать локальные переменные; отладчик ожидает правильную последовательность событий; сборщик мусора должен видеть живые значения; конструктору после super() ещё требуется продолжение. А любая аллокация на пути может закончиться нехваткой памяти, после которой браузер обязан корректно вернуть ошибку без падения.
Наконец, хвостовой вызов может вести не в обычную JavaScript-функцию. Целью бывает встроенная функция, bound function, Reflect.apply, callable Proxy или функция, предоставленная DOM. Для них понадобился трамплин: он повторяет диспетчеризацию, пока цепочка остаётся хвостовой, не наращивая ни регистровый, ни C++-стек. В результате взаимная рекурсия может бесконечно перескакивать между обычными, связанными, встроенными и проксированными функциями, сохраняя постоянный объём памяти.
XXII.V Подчищаем хвосты
Тут я чувствую себя обязанным рассказать вам кое о чём. После реализации proper tail calls я вдруг задумался — а почему этой оптимизации нет ни в V8, ни в SpiderMonkey? Это по меньшей мере странно.
Но эта странность объясняется проще, чем можно было бы подумать. Оптимизация хвостовых вызовов (TCO) переиспользует кадры стека. Если глубоко внутри хвостовой рекурсии произойдёт ошибка, Error().stack покажет вам только самую верхнюю и самую нижнюю функции. Весь путь, которым программа туда пришла, исчезнет. Счастливой отладки!
К тому же код, заточенный под хвостовую рекурсию, становится хрупким. Функция, написанная с расчётом на эту оптимизацию,
"use strict";

function myFunc(value) {
    value = someOtherFunc();
    return myFunc(value);
}
работает шикарно до тех пор, пока кто-то не сделает так:
"use strict";

function myFunc(value) {
    value = someOtherFunc();
    return myFunc(value) + 0;
}
Семантика не меняется, но оптимизация перестаёт работать — и стек переполняется.
Чтобы решить проблему, команды Microsoft и Mozilla предложили спецификацию синтаксических хвостовых вызовов (STC), которую поддержал и V8. Суть была в том, чтобы заставить программиста явно указывать, что он хочет TCO в обмен на потерю стек-трейса. Например, с помощью нового синтаксиса:
"use strict";

function myFunc(value) {
    value = someOtherFunc();
    return continue myFunc(value);
}
Но эту спецификацию так никогда и не приняли в стандарт.
V8 несколько лет поддерживал TCO через флаг, но потом весь связанный код удалили.
Узнав это, я поступил похожим образом — не удалил реализацию, а вывел её отдельным переключателем в opera:config, оставив включённой по умолчанию.
XXII.VI «Небольшая формальность»
Оставалась небольшая формальность: доказать, что всё это действительно ES2015.
Официальный набор Test262 живёт вместе с языком. Тест, добавленный сегодня в каталог Array, может проверять правило 2024 года, хотя сами массивы существовали в 1997-м. Метка es6id есть далеко не у каждого старого теста, современная метка раздела не указывает редакцию, а feature-теги со временем объединяют исходную возможность с её поздними расширениями. Просто взять нынешний Test262 и отфильтровать файлы по слову ES6 невозможно.
Это привело к парадоксальной задаче: прежде чем закончить реализацию стандарта, пришлось восстановить сам набор требований стандарта.
Для этого был написан классификатор, проверяющий каждый тест языка, встроенных объектов и Annex B. Базой идентификации стали имеющиеся теги es5id/es6id, номера разделов официальной шестой редакции и признаки возможностей. Сверху легли явные исключения для того, что появилось позже: BigInt, флаг регулярных выражений v, Object.values, Array.prototype.flat, поздняя семантика TypedArray, изменённые правила Date, Function.prototype.toString и ещё десятки менее очевидных поправок. ECMA-402 с объектом Intl классифицируется отдельно и в языковой результат не входит.
По итогам аудита получилось 25 664 файла, разворачивающихся в 48 414 кейсов — многие исходники исполняются отдельно в обычном и strict-режимах.
Но не всё так просто. Например, нашлась пара десятков тестов для более поздних спецификаций, которые движок проходил по причинам, вообще не заложенным в логику. Возможно, случайное совпадение в граничных условиях; так или иначе, все такие «зелёные» тесты пришлось разобрать вручную, чтобы исключить «мнимые» успехи.
XXII.VII Что теперь умеет Carakan?
Короткий ответ: Carakan теперь проходит весь применимый набор требований ECMA-262 шестой редакции.
Речь не только об очевидном наборе: классы, стрелки, let/const, шаблонные строки, деструктуризация, модули, генераторы, итераторы, Promise, Symbol, Map и Set. Появились Proxy и Reflect, typed arrays и ArrayBuffer, well-known symbols, новые правила встроенных объектов, Unicode в строках и регулярных выражениях, Annex B для совместимости со старым вебом, области видимости, eval, realm-ы и правильные хвостовые вызовы. А механизм async/await, добавленный по дороге, уже выходит за границы ES2015 и относится к ES2017.
Разумеется, никакая тестовая сюита не может доказать отсутствие неизвестного бага в каждой строчке спецификации. Практическое утверждение здесь точнее: все найденные и классифицированные требования редакции покрыты, а весь их воспроизводимый набор проходит. На случай, если обнаружится пропуск, у нас есть понятные инструменты, чтобы исправить его, не размывая границу стандарта.
Для практического веба это огромный переход. Скрипт больше не исчезает целиком на первой стрелке или class; библиотеке не обязательно приносить собственный Promise; приложение может загрузить граф модулей и пользоваться стандартным протоколом итерации. Благодаря этому теперь можно запускать современную тестовую инфраструктуру WPT без Babel-транспиляции.
Но это не следует читать как «Opera теперь поддерживает современный JavaScript». Нет.
Полный нынешний Test262 в зафиксированной версии содержит 92 886 случаев. Carakan исполняет 89 908 из них и проходит 55 246; 34 662 заканчиваются неудачей, ещё 2 978 блокируются тестовым окружением. В этих красных строках находятся последующие одиннадцать лет развития языка: BigInt, public и private class fields, async iteration, SharedArrayBuffer и Atomics, новые методы массивов и Promise, поздние режимы RegExp, dynamic import, top-level await, WeakRef, Temporal и многое другое.
Даже названия категорий современного отчёта могут вводить в заблуждение. Если там есть падения в группе class, это не значит, что не работает class из 2015 года: в ту же группу Test262 складывает приватные поля, статические блоки, декораторы и позднейшие уточнения. Поэтому «частичная поддержка» на детекторе возможностей и точное прохождение шестой редакции вполне могут быть правдой одновременно — они отвечают на разные вопросы.
Отдельно отсутствует полноценный ECMA-402 Internationalization API, то есть Intl. Он никогда не был частью Carakan и не входит в ECMA-262. Исправленный localeCompare, форматирование дат силами платформы и таблицы Unicode — это не замена Intl.Collator, Intl.DateTimeFormat, правилам локалей и многомегабайтным данным CLDR. Для этого выбран отдельный путь с ICU и это отдельная большая работа.
Есть и ограничения производительности. Генераторы, async-функции, часть сложных параметров и функции с правильными хвостовыми вызовами остаются в интерпретаторе. Proxy по самой своей природе закрывает некоторые объектные fast path. Новый код работает правильно, но не всегда проходит через тот JIT, которым Carakan в 2010 году обгонял конкурентов. JIT-компилятор под это дело придётся писать, фактически, заново, а это работа такой сложности, которую я просто не могу оценить. Логика и осторожность диктуют браться за JIT (если браться вообще) только тогда, когда вся реализация JS будет окончательно доведена до ума. И предварительно запастись душевным здоровьем.
И, наконец, JavaScript — только один слой браузера. Прохождение языковой спецификации не добавляет CSS Grid, Shadow DOM, HTTP/2 и отсутствующие Web API. Оно снимает один фундаментальный барьер и позволяет странице дойти до следующего.
XXIII. Проигрыватель, который ничего не проигрывает
Поддержка мультимедиа в Opera сделана на базе GStreamer 0.10, который было бы неплохо обновить (я расскажу, почему). Поначалу мне казалось, что это будет работа, схожая с переездом на OpenSSL, только большего масштаба.
Как же я ошибался.
GStreamer нельзя обновить так же, как, например, библиотеку декодирования картинок. Это не кодек и не проигрыватель, а конструктор медиаконвейеров: один элемент получает байты, другой распознаёт контейнер, следующие декодируют звук и видео, ещё одни преобразуют форматы, синхронизируют потоки и отдают результат звуковому устройству или приложению. Opera встроилась в этот конструктор сразу с двух сторон: добавила два собственных элемента, подменила части нескольких чужих плагинов и связала многопоточную модель GStreamer с однопоточным ядром Presto. Интеграция получилась довольно замороченной (хотя и удивительно хорошо сделанной; подробнее я разберу её ниже), и это первая сложность. Вторая — GStreamer 1.x полностью несовместим с 0.10. Ну, или по крайней мере выглядит таковым.
Для начала стоит разобраться, где в браузере вообще находится медиаплеер. Ответ «в модуле media» логичен, очевиден и не вполне верен.
modules/media реализует поведение HTML-элементов <audio> и <video>: состояния загрузки, play() и pause(), события, диапазоны буферизации, перемотку, громкость, выбор источника и отношения с сетевым кешем. Он знает, что видео должно остановиться, если данных недостаточно, и что после перемотки нужно дождаться нового кадра. Декодировать этот кадр он не умеет.
Ниже находится платформенный интерфейс OpMediaPlayer. Это аккуратная граница между логикой Presto и конкретным мультимедийным фреймворком. Ядро передаёт проигрывателю источник данных и просит начать, остановиться, сменить позицию или вернуть последний кадр в виде OpBitmap; в обратную сторону приходят сообщения об изменении длительности, новом размере видео, окончании воспроизведения и ошибках. Рядом живёт OpMediaManager, отвечающий на вопросы вида «можно ли проиграть video/webm с VP8 и Vorbis?» и создающий экземпляры проигрывателя.
Наконец, платформенный бэкенд реализует этот интерфейс. В доступной конфигурации Opera 12 он был ровно один: GStreamer. Не DirectShow под Windows и не что-нибудь специфичное для Linux, а один общий код в platforms/media_backends/gst.
Для кода 2008–2011 годов это на редкость достойный архитектурный подход, и он сильно упростил задачу. Код HTML media и публичный платформенный интерфейс не пришлось переписывать: вся операция состоялась по другую сторону уже существующего шва.
XXIII.I Немного раскопок вокруг GStreamer
Когда этот бэкенд писался, GStreamer 0.10 был основной стабильной версией фреймворка. Ветка 1.0 появится только в сентябре 2012 года, а официально несовместимой её объявят с самого первого релиза. Проектирование же оперовского кода началось несколькими годами раньше. Поэтому сам выбор 0.10 не был устаревшим или консервативным: другого зрелого GStreamer тогда просто не существовало.
Выбор GStreamer тоже был вполне рационален. Браузеру не хотелось самостоятельно реализовывать демультиплексирование Ogg и WebM, декодирование Theora, Vorbis и VP8, звуковой вывод, медиачасы, очереди и синхронизацию аудио с видео. Всё это уже умел GStreamer, причём одинаково для нескольких операционных систем. Опере оставалось решить две задачи, специфичные именно для браузера: откуда брать байты и куда девать готовый видеокадр.
Для первой был написан собственный элемент operasrc. Передавать GStreamer исходный URL было нельзя: в таком случае тот пошёл бы в сеть самостоятельно. Вместо этого operasrc запрашивал нужный диапазон у OpMediaSource, а тот читал его из уже существующей сетевой подсистемы Opera. Браузерная часть осталась у браузера, плеерная часть получала только необходимые ресурсы.
Для второй задачи появился operavideosink. Обычный видеоплеер может открыть собственное окно или рисовать в системную поверхность. Браузер так не может: ролик должен участвовать в раскладке страницы, обрезаться, перекрываться другими элементами, масштабироваться и проходить через графический движок VEGA. Поэтому operavideosink забирал декодированный кадр, превращал его в OpBitmap, а дальше Opera рисовала его как часть документа. Звук, напротив, не требовал участия рендерера и шёл через стандартную цепочку audioconvert ! audioresample ! volume ! autoaudiosink к системному аудиовыходу.
Отдельная проблема заключалась в потоках. GStreamer обрабатывает данные в собственных рабочих потоках, а ядро Opera в целом потокобезопасным не является. Поэтому в бэкенде ещё тогда завели верное правило: не вызывать Opera из GStreamer напрямую. Рабочий поток публиковал запрос на чтение, будил главный поток браузера и ждал ответа; сообщения из GStreamer забирались через GstBus, без обратных вызовов в глубину движка. Копий памяти старались делать как можно меньше, но границу владения соблюдали строго.
Именно этим объясняется кажущаяся избыточность исходной реализации. operasrc и operavideosink — это два минимально достаточных адаптера между подсистемами с несовместимыми правилами владения данными, потоками и временем жизни объектов.
XXIII.II Linux, Windows и одна маленькая DLL
Исходный код бэкенда был общим, но поставлялся он на разных платформах принципиально по-разному.
Под Linux Opera ожидала GStreamer 0.10 в системе. Заголовки и библиотеки приходили из пакетов дистрибутива, плагины находились через обычный реестр GStreamer. Это соответствовало традиции Linux: мультимедийный стек общий для приложений, дистрибутив сам обновляет его и решает, какие кодеки разрешено распространять.
Под Windows полагаться было не на что, поэтому Opera несла собственный комплект GStreamer 0.10.x для x86 и x64. Причём это был не обычный набор из дистрибутива: центральный gstreamer.dll представлял собой слинкованную комбинацию нескольких библиотек, рядом лежали одиннадцать выбранных плагинов, а поддержка WebM была вкомпилирована в Opera.dll.
При этом Opera не линковалась с GStreamer обычным образом. Имена нужных функций хранились в файлах .symbols, скрипт генерировал таблицу указателей, а OpDLL загружал библиотеки во время работы. Если GStreamer отсутствовал или не хватало хотя бы одного символа, браузер всё равно запускался — просто медиабэкенд считался недоступным. Для Linux это позволяло сделать мультимедиа необязательной зависимостью, а для Windows — держать комплект собственных библиотек рядом с браузером, не регистрируя его в системе.
С точки зрения форматов Opera придерживалась тогдашней политики свободных кодеков: Ogg с Theora/Vorbis, WebM с VP8/Vorbis и WAV. MP4, H.264 и AAC намеренно не поставлялись из-за патентных и лицензионных рисков. Ради гарантированной поддержки тогда ещё молодого WebM в дерево попали форки Matroska-демультиплексора и VP8-плагина, а также полный libvpx 1.1.0. Это большая кодовая база: тринадцать тысяч строк кода, плюс 31 мегабайт исходников libvpx, требующих для сборки ассемблера yasm и отдельной сборочной инфраструктуры. Зато результат не зависел от того, успел ли конкретный дистрибутив добавить новый формат.
XXIII.III Смерть GStreamer 0.10
В сентябре 2012 года вышел GStreamer 1.0. Авторы предупреждали, что новая ветка несовместима с 0.10 на уровне API и ABI, хотя обе можно установить параллельно. В марте 2013 года последовало ещё более прямое объявление: GStreamer 0.10 больше не поддерживается, новых релизов не будет, исправления туда не переносятся. По исторической иронии, это произошло почти одновременно с заморозкой Presto.
Поначалу это не мешало: в дистрибутивах оставались пакеты 0.10, а Windows-комплект ездил вместе с браузером. Ну а потом Presto с GStreamer 0.10 умерли, и это перестало быть важным.
В современном Debian пакетов GStreamer 0.10 уже давно нет, параллельно установленная 1.x старому приложению не помогает, потому что для практических целей это другая библиотека с другими именами и плагинами. Динамический загрузчик Opera ищет libgstreamer-0.10, не находит и отключает бэкенд, лишая браузер поддержки <audio> и <video>.
Под Windows всё немного лучше: пока старые DLL собираются, аудио и видео продолжают работать — на том же уровне, что и четырнадцать лет назад: ни Opus, ни VP9, ни новых исправлений контейнеров.
XXIII.IV Почему снова GStreamer?
Самый естественный вопрос: если порт настолько сложен, почему бы не выбросить GStreamer целиком? Я подумал над вариантами.
— FFmpeg. Он современен, распространён и прекрасно декодирует почти всё. Но FFmpeg — прежде всего набор библиотек для работы с форматами и кодеками. Из него можно получить аудиосэмплы и видеокадры; дальше браузеру всё равно нужны очереди, часы, синхронизация, управление паузой и перемоткой, вывод через ALSA или PulseAudio под Linux и через Windows API под Windows. В дереве Presto собственного универсального звукового слоя для этого нет. Замена GStreamer на FFmpeg означала бы не смену одной библиотеки, а написание половины медиаплеера для двух платформ.
— Системные API: Media Foundation под Windows, тот же GStreamer под Linux. Технически это возможно, интерфейс OpMediaPlayer как раз допускает разные реализации (и наверняка это где-то использовалось, но без платформенных исходников уже не узнать). Практически мы получили бы два больших бэкенда с разным набором форматов, разными ошибками, разной буферизацией и удвоенной стоимостью тестирования. Сомнительная перспектива.
— Плагины. Идея вкорячить поддержку мультимедиа таким образом звучит странно, но интереса ради я посмотрел и это. И действительно, подобный механизм даже существует: сайт мог явно встроить установленный NPAPI-плагин — VLC, QuickTime или другой — в отдельном <object>. Но NPAPI давно мёртв во всех основных браузерах, не говоря уж о том, что такой костыль явно бы нарушил все границы модулей ради неочевидного результата.
На будущее: в интерфейсе есть CanPlayURL() — платформенный плеер может заявить, что сам умеет открыть, например, rtsp://, не используя сетевой кеш Opera. Это удобная точка расширения, но возможность когда-нибудь написать такой код и наличие этого кода — разные вещи.
— Наконец, можно вынести декодирование в отдельный процесс через OpComponent, полностью написав передачу кадров, звука, запросов диапазонов и состояния проигрывания через новый IPC-протокол. С точки зрения безопасности это и вовсе предпочтительная конечная архитектура: ошибка парсера не должна компрометировать весь браузер. Только вот OpComponent сам по себе не находится в том состоянии, чтобы это позволить, и его доработка — проект ещё более объёмный, чем восстановление мультимедиа-бэкенда.
Вот и остаётся GStreamer 1.x. Он сохраняет главное преимущество старого решения: один медиаконвейер для обеих платформ, готовые демультиплексоры, декодеры, часы и аудиовывод. Он позволяет оставить интерфейс OpMediaPlayer, сетевой кеш и HTML media нетронутыми. И, что важно, он не заставляет нас расширять набор поставляемых патентованных кодеков: Windows можно снабдить только выбранными свободными плагинами, а Linux — пользоваться тем, что разрешил и установил дистрибутив или пользователь.
XXIV. Замена проигрывателя на выигрыватель
Простите за древний каламбур в заголовке — иногда я правда не могу удержаться.
Официальное руководство по переходу с GStreamer 0.10 на 1.0 ободряюще сообщает, что простое приложение можно портировать меньше чем за день. Это правда.
Ещё это совершенно бесполезная информация для приложения, которое реализовало два собственных GStreamer-элемента и залезло внутрь модели буферов.
XXIV.I Лёгкие восемьдесят восемь процентов
Работа началась с инвентаризации. Динамический загрузчик Opera использовал 140 функций GStreamer и GLib. Из них 122 сохранились в GStreamer 1.x. Это почти 88 процентов, и именно они оказались лёгкой частью.
Скрипт, генерирующий таблицы символов, был переведён на Python 3 (я уже потерял счёт python-автоматизациям), загрузчик перенастроен на библиотеки gstreamer-1.0, gstbase-1.0, gstvideo-1.0, gstapp-1.0 и GIO. Заодно выяснилось, что старый парсер деклараций способен принять вызов функции за её объявление; это тоже пришлось исправить, иначе генератор создавал убедительно выглядящую, но неверную сигнатуру. Загрузка осталась динамической: Opera по-прежнему не линкуется с импортными библиотеками GStreamer и откатывает инициализацию целиком, если комплект неполон.
Многие изменения действительно были механическими. decodebin2 стал decodebin, сигнал new-decoded-pad — обычным pad-added, ffmpegcolorspace заменился на videoconvert, старые video/x-raw-rgb и video/x-raw-yuv объединились в video/x-raw. Прямой доступ к полям GstBuffer сменился отображением памяти через gst_buffer_map(), а кадр теперь приходит как GstSample, в котором отдельно лежат buffer и caps. Всё это хорошо документировано и довольно быстро чинится.
Проблема заключалась в оставшихся восемнадцати символах. Они не были случайным набором удалённых функций: почти все указывали на три архитектурных разлома — источник данных, видеобуферы и индекс соответствия байтов и времени.
GStreamer 1.0 именно для этого и ломал совместимость. В анонсе релиза перечислены новая модель памяти, расширяемые метаданные буферов, отделение согласования caps от выделения памяти и более строгая работа динамических конвейеров. Это отличные улучшения внутри фреймворка, но для Opera, которая наследовалась от GstBuffer и управляла его освобождением, это демонтаж фундамента.
XXIV.II Источник, который должен уметь возвращаться
На первый взгляд, operasrc проще всего было заменить стандартным appsrc. Элемент как будто создан ровно для этого: приложение получает need-data, кладёт байты в очередь, при перемотке отвечает на seek-data. Сначала я так и сделал.
Линейное воспроизведение заработало. Затем выяснилось, что длительность Ogg определяется неверно, а произвольной перемотки нет. В потоковом режиме appsrc последовательно проталкивает данные вперёд — этого достаточно, чтобы однажды дойти до конца файла, но демультиплексоры обычно предпочитают pull mode: сами запрашивают конкретные диапазоны, заглядывают в конец контейнера, возвращаются к таблицам сэмплов и читают нужный ключевой кадр. Старый operasrc, будучи наследником GstBaseSrc, такой контракт поддерживал.
У appsrc документированы режимы seekable и random-access, поэтому следующим очевидным шагом было включить один из них. На реальном GStreamer 1.26.2 оба варианта в нашем конвейере застряли в READY: decodebin не открыл ни одного смещения, длительность не появилась, воспроизведение не началось. Это один из случаев, когда наличие подходящего свойства в справочнике ещё не доказывает пригодность элемента для конкретного pull-mode-контракта.
Тогда я попробовал пойти тем же путём, что и инженеры Opera когда-то: написать собственный наследник GstBaseSrc, фактически вторую версию operasrc. Естественно, когда она уже была готова и успешно работала, я обратил внимание на штатный giostreamsrc, который делал то же самое, только лучше. Как бы я ни любил велосипеды, правильно было использовать giostreamsrc, не столько из-за скорости, сколько потому, что GStreamer уже умеет управлять состояниями GstBaseSrc, pull mode, отменой через GCancellable и разблокировкой при остановке. Ну и это чище архитектурно: в Opera остался только переходник данных — GstOperaInputStream.
Интересно, что WebKit пришёл почти к тому же решению. GStreamer-бэкенд WebKit в своё время тоже ушёл от простого appsrc к собственному источнику, который адаптирует поток GStreamer к сетевому слою браузера. Это не доказывает единственность решения, но хорошо подтверждает природу задачи: браузерный ресурс — не файл и не обычный push-stream, а асинхронный кеш с произвольными диапазонами и строгой принадлежностью потоку.
Новый мост устроен почти так же, как старый, только граница стала уже. Поток GStreamer вызывает read() у нашего GInputStream. Тот под блокировкой публикует точные offset и size, отправляет сообщение в главный цикл Opera и засыпает. Главный поток читает диапазон из OpMediaSource, возвращает байты и будит GStreamer. Никакой сетевой или кеширующий код не исполняется в чужом потоке.
Любопытно, как GStreamer проверяет перематываемость объекта: не по какому-нибудь флагу, а по наличию интерфейса GSeekable. Если размер данных неизвестен или поток линейный, OpMediaSource не должен создавать этот интерфейс вовсе.
Самая неприятная часть такого моста — уничтожение. В момент закрытия страницы GStreamer может ждать байты, главный поток — снимать callbacks, а поток плеера — ожидать завершения GStreamer. Неправильный порядок даёт идеальный deadlock. Поэтому адаптер сначала переводится в состояние abort и будит все ожидающие стороны, затем останавливается конвейер, и лишь после этого освобождаются объекты. В старом коде рядом с аналогичным местом уже стоял комментарий, что gst_operasrc_quit обязан случиться до g_thread_join. Этот комментарий не потерял актуальности даже при пересобранном фундаменте, хоть имена функций теперь и другие.
XXIV.III Буфер, от которого нельзя наследоваться
С видеовыходом всё вышло наоборот. Его поведение было простым, а реализация — намертво привязанной к GStreamer 0.10.
Старый operavideosink наследовался от GstVideoSink, принимал кадры в формате xRGB и хранил последний из них. Для повторного использования памяти он создал ещё и собственный тип буфера, унаследованный от GstBuffer: переопределённый finalize не освобождал память, а возвращал объект во внутренний пул. В 0.10 GstBuffer поддерживал наследование через GType, в 1.x буфер стал особым мини-объектом с отдельными блоками GstMemory и расширяемыми метаданными; наследовать его через GType больше нельзя, buffer_alloc у base sink исчез, а caps перестали прикрепляться к каждому буферу старым способом.
К счастью, в новой архитектуре есть штатный appsink: он складывает готовые GstSample в ограниченную очередь, а приложение забирает их в своём темпе. Собственный operavideosink оказался не нужен вообще. GStreamer сообщает лишь о появлении sample, главный поток Opera безопасно забирает его, проверяет caps и размер строки, отображает память и копирует пиксели в OpBitmap.
Копия сохранилась намеренно. Хотелось бы передавать GStreamer указатель прямо на память OpBitmap, но фреймворк может удерживать ссылки на buffer после того, как Opera считает кадр обработанным. Без нового контракта владения это закончится либо использованием освобождённой памяти, либо картинкой, в которую декодер пишет во время отрисовки. Для настоящего zero-copy пришлось бы менять сам интерфейс OpMediaPlayer, а не только бэкенд; оптимизация стоящая, но пока отложенная.
Для фронтенда ничего не изменилось: VEGA по-прежнему получает обычный OpBitmap, HTML-элемент по-прежнему узнаёт о новом кадре через OnFrameUpdate.
XXIV.IV Индекс, которого больше нет
Последняя несовместимость была наименее заметной и оказалась самой коварной.
HTML media спрашивает у проигрывателя не только текущую позицию, но и какие диапазоны уже загружены. Сетевой кеш знает диапазоны в байтах; интерфейс страницы ожидает секунды. Старый GStreamer заполнял GstIndex, где демультиплексор сохранял соответствия вроде «байт 1 247 391 — время 5,2 секунды». Opera брала ближайшие точки до и после границы кеша и интерполировала между ними. Если индекса не было, использовалась средняя скорость потока по всему файлу.
В GStreamer 1.x GstIndex удалён без прямой замены. Можно спросить у элемента GST_QUERY_CONVERT: преобразуй байтовое смещение во время или обратно. Но запрос к верхнему pipeline даёт неожиданный результат — на него способен ответить аудиовыход, который решит, что переданное число байтов относится к несжатому PCM, и вычислит совершенно бесполезную длительность. Спрашивать нужно именно демультиплексор внешнего контейнера.
decodebin создаёт этот демультиплексор динамически в рабочем потоке и так же динамически удаляет при смене состояния. Opera теперь отслеживает первый подходящий элемент, удерживает на него собственную ссылку и задаёт запрос напрямую. При этом главный поток не имеет права ждать, пока GStreamer завершит seek, flush или разрушение конвейера: иначе исправление индекса снова превращается в deadlock. Поэтому код пытается взять рекурсивную блокировку состояния без ожидания. Получилось — задаёт точный запрос. Не получилось — использует безопасную линейную оценку.
Точность зависит от контейнера. qtdemux умеет отвечать по таблицам сэмплов, WAV имеет постоянную скорость, а актуальные oggdemux и matroskademux не дают нужного нелинейного преобразования для всего ресурса. Для Ogg и WebM границы буферизации поэтому оцениваются пропорционально размеру файла; начало и конец принудительно закреплены точно. Вероятно, перемотка всё равно останется не совсем точной, но это лучшее, что я смог придумать.
XXIV.V Минус 260 тысяч строк
На этом как будто всё. И, как всегда после такого переезда, стало чуть проще.
Код самого GStreamer отъехал из репозитория: минус тысяча файлов и 260 тысяч строк. GStreamer-плагин, форкнутые демультиплексор и декодер, libvpx 1.1.0, вендорные заголовки, оба Windows-рантайма и их сборочные цели — их больше нет. Больше не нужен yasm, а время сборки уменьшилось процентов на двадцать. Но сами исходники GStreamer для сборки всё ещё требуются — пакет приходится устанавливать отдельно, примерно так, как это уже делается с исходниками OpenSSL.
Linux-билд тестировался с GStreamer 1.26.2 из Debian. Он загружает системные библиотеки и читает системный реестр плагинов, поэтому точный набор форматов зависит от того, что предоставляет дистрибутив, и от того, что добавил сам пользователь.
Windows получил собственный минимальный рантайм из официальной поставки GStreamer 1.28.5 для MSVC. В него вошли 24 основные DLL, 17 выбранных плагинов, вспомогательный gst-plugin-scanner, зависимости GLib и кодеков, а также локальный Visual C++ Runtime. В каждой архитектуре получилось 42 бинарных файла: около 15,5 МБ для x64 и 12,9 МБ для x86. Состав ограничен элементами для GIO-входа, Ogg/Theora, WebM/VP8 или VP9, WAV, преобразования аудио и видео, а также вывода звука через DirectSound. Декодеров H.264 и AAC там нет.
Почему не скопировать весь официальный каталог? Потому что «поставить GStreamer» означает поставить не одну библиотеку. Плагины обнаруживаются через реестр и отдельный сканер, DLL зависят от GLib, libffi, PCRE2, ORC, zlib и кодеков, а случайно попавший в комплект плагин меняет ответ canPlayType() и лицензионную политику браузера. Минимальный список делает возможности Windows-версии воспроизводимыми.
В то же время выдёргивать отдельные DLL на глаз нельзя: GStreamer ожидает собственную структуру каталогов, а динамический загрузчик Windows может найти несовместимую системную зависимость раньше локальной. Поэтому Opera сначала атомарно загружает и удерживает полный утверждённый набор зависимостей из своего каталога, затем запускает GStreamer и указывает ему локальный путь к плагинам и сканеру. Если любой обязательный файл не загрузился, не остаётся наполовину инициализированного рантайма — вся операция откатывается.
Это работает так, как и было задумано когда-то, только лучше.
XXV. Что дальше?
И вот тут я пока не знаю, что пообещать. Из очевидного — полировка ES6, шероховатостей ещё предостаточно. Очень вероятно — Shadow DOM. Какие-то попутные улучшения CSS — наверняка, но вряд ли что-то крупное.
Попутно я ковыряюсь в Quick UI. Он очень классно сделан технически, но внутренний дизайн UI Оперы довольно сильно устарел, и я кое-что хотел бы в нём изменить.
Хочется доработать внутренний отладчик. Возможно, доработать то, что есть внутри (там не очень много), либо восстановить Dragonfly.
Вопрос не в том, что делать дальше — просторы для приложения сил поистине бесконечны. Вопрос в том, когда каждое изменение дойдёт до какого-то вменяемого состояния. Все эти фичи большие, трудозатратные и очень интересные.