The Engine We Lost: Digital Archaeology of Opera Presto
Opera Dragonfly и Shadow DOM
Оглавление
- XXVI. Эпоха до F12: Alert-Driven Development
- XXVII. Dragonfly: вещь в себе
- XXVIII. Что не умеет Dragonfly?
- XXIX. История Shadow DOM и зачем он нужен
- XXX. Мнимая простота
- XXXI. Что дальше?
На этой неделе я расскажу о двух подсистемах, которые наконец готовы. Одна из них старая, заведённая «с толкача»; речь о великолепном отладчике Opera Dragonfly. Вторая же система — абсолютно новая реализация API Shadow DOM.
Это далеко не единственные улучшения и исправления, которые Presto получил за прошедшую неделю. Дорабатывается CSS, дописываются новые Web API, начат совершенно гигантский трек доработок ECMAScript. Наконец, система сборки языковых файлов переписана с Perl на Python, и выкинут 7zip — архивация есть и в Python, и в современных ОС напрямую. Тулинг теперь упрощён до предела.
XXVI. Эпоха до F12: Alert-Driven Development
Сегодня для любого веб-разработчика клавиша F12 (или Ctrl+Shift+I) — это безусловный рефлекс. Вёрстка поехала? F12, клик по элементу, правим CSS прямо в браузере. Скрипт упал? F12, консоль, клик по стектрейсу, мы в отладчике. Запрос завис? Вкладка Network разложит каждый запрос-ответ на составляющие. Современные DevTools — это приборная панель, позволяющая изучить и изменить состояние любой подсистемы.
Но веб начала двухтысячных писался вообще без приборов. Мы летели сквозь туман по пачке «Беломора».
Если вы не застали те времена, вам будет сложно поверить, насколько мучительным был процесс создания и отладки даже простых страниц. У нас был ровно один встроенный в браузер инструмент для инспекции — кнопка «Просмотр кода страницы» (View Source).
Проблема «View Source» заключалась в том, что он показывал статичный текст, пришедший от сервера. Если ваш JavaScript модифицировал DOM, добавлял узлы или менял классы — вы этого не видели. Вы смотрели на исходный HTML и пытались в уме смоделировать, как он должен выглядеть после того, как по нему прошлись ваши скрипты. Мы были похожи на первобытных программистов, которые компилируют программу в голове, прежде чем дырявить перфокарты.
Как отлаживали вёрстку? Методом красной рамки. Если флоаты (float) разъезжались, а табличная вёрстка отказывалась центрироваться, разработчик открывал свой текстовый редактор, находил подозрительный блок и писал:
border: 1px solid red;
Сохранить. Альт-таб в браузер. F5. Посмотреть, где оказалась красная линия. Ага, блок вылез за пределы родителя. Альт-таб обратно. Добавить border: 1px solid blue; соседнему элементу. Сохранить. F5. Повторять до просветления.
С JavaScript всё было ещё драматичнее. Никакого console.log не существовало, потому что не было самой консоли. Если в скрипте была синтаксическая ошибка, Internet Explorer 6 мог показать в левом нижнем углу крошечный жёлтый треугольник с восклицательным знаком. При клике на него выдавалось абсолютно бесполезное сообщение в духе: «Ошибка на строке 42: Предполагается наличие объекта». Что за объект? Почему на строке 42, если у меня в файле их всего 20? Разбирайся сам.
Главным и единственным инструментом отладки JS был alert().
Это называлось Alert-Driven Development. Чтобы понять, доходит ли выполнение до нужной ветки if, вы вписывали alert('here'). Чтобы проверить значение переменной — alert(myVar).
И здесь вас поджидали две катастрофы. Первая: если переменная была объектом, браузер выводил вам окошко с текстом [object Object], не давая никакой информации о его внутренностях. Вторая: если вы случайно забыли alert внутри цикла на десять тысяч итераций, вам оставалось только убивать процесс браузера через Диспетчер задач, потому что модальное окно блокировало всё насмерть.
В какой-то момент Microsoft выпустила отдельный тяжеловесный Microsoft Script Debugger, а у Mozilla появился DOM Inspector — перегруженный, неинтуитивный монстр, работавший скорее как утилита для отладки самого движка Gecko, а не веб-страниц.
Всё изменилось в январе 2006 года.
Имя человека, навсегда изменившего веб-разработку — Джо Хьюитт (Joe Hewitt). Именно он создал Firebug — расширение для Firefox, которое разделило историю фронтенда на «до» и «после».
Firebug не был первым отладчиком в истории, но он первым реализовал парадигму, к которой мы сейчас привыкли. Он дал нам живое дерево DOM, где узлы можно было разворачивать кликом, а изменения, внесённые скриптами, отображались в реальном времени. Он дал нам инспектор стилей, где CSS-свойства можно было включать и выключать галочками. Он дал нам console.log() и человеческую консоль вместо бесконечных алертов. Он показал водопад сетевых запросов.
Firebug был настолько невероятно, крышесносно удобен, что веб-разработчики массово пересаживались на Firefox только ради него. Доля «огнелиса» стремительно росла, и другие производители браузеров поняли: инструменты разработчика — это мощнейшее конкурентное преимущество. Инструменты надо встраивать прямо в браузер (позже так появится WebKit Web Inspector, эволюционировавший в современные Chrome DevTools).
Opera Software, с её принципом «мы всё делаем сами и делаем это концептуально», не могла остаться в стороне. Им нужен был свой ответ Firebug. Ответ мощный, быстрый, кроссплатформенный и, желательно, способный отлаживать страницы не только на десктопе, но и на мобильных устройствах, где Opera тогда правила бал.
Их ответ назывался Opera Dragonfly.
С инженерной точки зрения это был шедевр. Архитекторы Opera решили не вшивать UI отладчика в ядро браузера, а сделать его… обычным веб-приложением. Движок предоставлял по внутреннему протоколу (scope) доступ к своим кишкам, а сам интерфейс Dragonfly загружался из сети и общался с движком так же, как общался бы с удалённым сервером. Это изящно решало сразу две задачи: интерфейс отладчика можно было обновлять независимо от релиза самого браузера, а удалённая отладка телефона с десктопа работала буквально «из коробки» — достаточно было просто прокинуть порт.
Dragonfly и его средства разработки открыты под Apache-2.0, поэтому его можно изучать, менять и использовать без ограничений. Давайте этим и займёмся.
XXVII. Dragonfly: вещь в себе
Первое, что удалось проверить — работоспособность исходной версии «as is». Почти никаких проблем: собранный клиент загрузился из локального файла, поднял соединение по scope, показал DOM-дерево, каскад CSS, дерево ресурсов, localStorage и куки. Работает JS-дебаггер, однако он ожидаемо падает при разборе неизвестных JS-выражений.
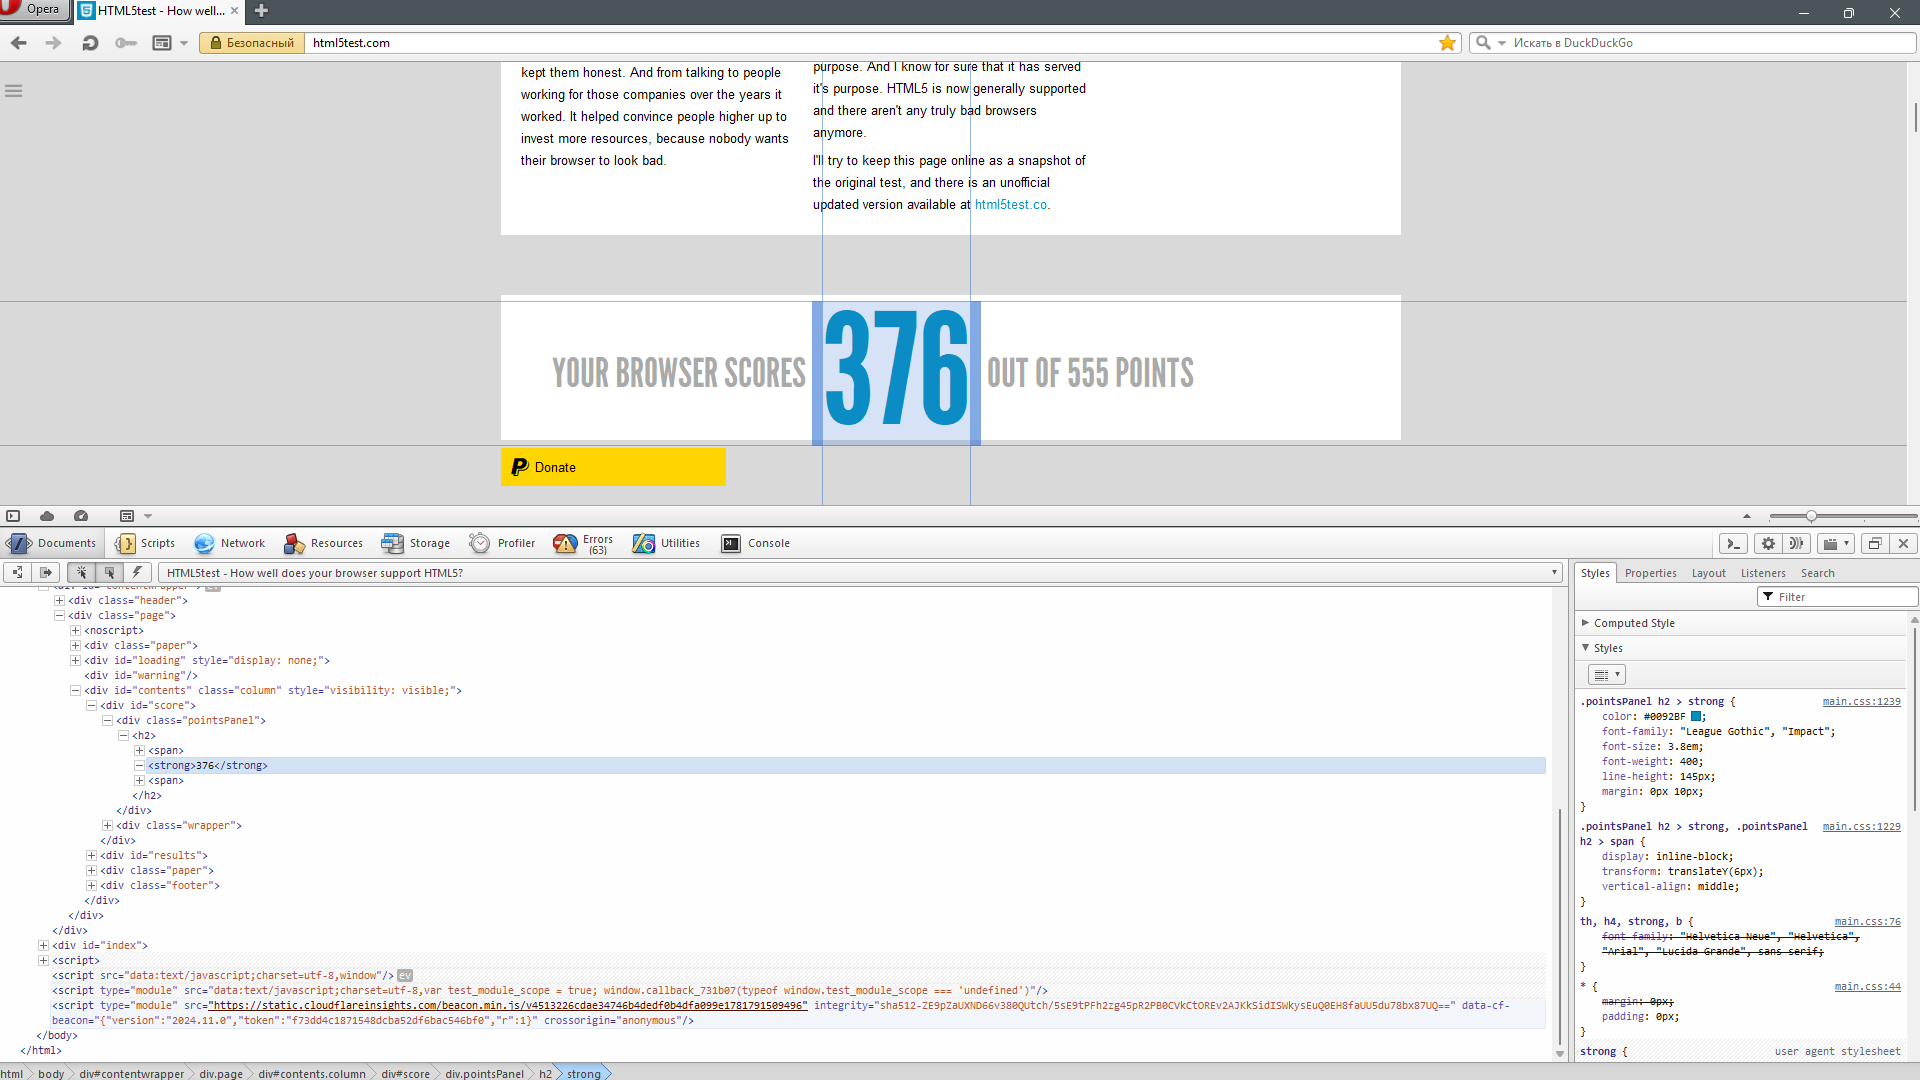
То, как он сделан — это квинтэссенция подхода Opera. Всё своё, независимое, и, чёрт побери, настолько хорошо спроектированное, что удивляет и по сию пору. Возьмём то, как отладчик взаимодействовал с браузером: мы уже знаем, что использовался собственный протокол scope, базирующийся на protobuf. Однако Dragonfly был настолько продвинут, что мог работать даже в Chrome и Firefox, которые о scope ничего не знали. В этих случаях Dragonfly сам реализовывал нужное API через прокси, причём несколькими способами. Это мог быть либо WebSocket на /stp-1-channel, либо длинный опрос GET /get-message с POST /post-command/<service>/<command>/<tag>.
Логично, что подобный клиент не может и не должен использовать UI браузера. Поэтому Dragonfly содержит собственный UI-фреймворк (построенный вокруг концепции, очень схожей с тем, что позже появится в спецификации Custom Elements), собственный менеджер компоновки, собственный шаблонизатор разметки и собственную логику локализации.
Всё это живёт в пяти мегабайтах исходников на JS/CSS/XML. Сборщиков два, оба на python 2: старый dfbuild.py и новый df2.py, оба делают примерно одно и то же — очистку комментариев, склейку кода, подстановку значений, минификацию и т.д. Впрочем, для работы клиента сборка не нужна — исходники прекрасно будут работать, как есть.
Всё. It just works. Я только для порядка переписал сборщик на python 3.
XXVIII. Что не умеет Dragonfly?
Было бы странно ожидать от отладчика десятилетней давности каких-то современных возможностей, хотя и тут не всё так однозначно. В Dragonfly заложено больше, чем он показывает — например, в нём есть подсистема для вызова селфтестов браузера (она никак не используется, просто существует) или готовые методы отладчика JS, которые не успели вывести в UI. Но это мелочи.
Список отсутствующего довольно большой. Dragonfly:
- не поддерживает Source maps;
- не разбирает кадры WebSocket (хотя сам протокол передачи поддерживается);
- не имеет инструментов для искусственного троттлинга;
- не эмулирует геометрию и вьюпорты;
- не имеет профилировщика памяти (отладчик умеет обходить объекты, но не собирает информацию о памяти);
- не поддерживает асинхронные стеки вызовов (логично, весь существующий стек синхронный);
- не инспектирует анимации и переходы;
- не поддерживает то, что не умеет сам Presto: flexbox, grid, Service Workers, IndexedDB, Cache Storage, Shadow DOM, пользовательские элементы.
Как инструмент 2012 года Dragonfly сопоставим с современниками и местами лучше их. Гранулярность профилировщика до отдельного CSS-селектора, конструктор HTTP-запросов, список обработчиков событий с исходниками, точки останова на DOM-событиях и настраиваемые горячие клавиши — всё это тогда было впереди рынка, а кое-что и сейчас не везде есть.
В реалиях 2026 года он годится для отладки страниц, которые Presto способен показать. Для отладки современного фронтенда его не хватит, но современный фронтенд в Presto пока что и не загрузится. И задумка здесь другая: собранные в Dragonfly ошибки помогут находить пробелы в движке.
XXIX. История Shadow DOM и зачем он нужен
Если вы когда-либо верстали веб-страницы, то хотя бы примерно представляете их структуру. Вот теги, описывающие элементы, вот их атрибуты, вот селекторы, по которым можно выбрать нужные элементы, и что-то на них навесить — правило стиля или обработчик скрипта. Всё, как на ладони, и для разработчика, и для любого клиентского кода.
Но вот на странице появляется тег <video> — и это уже не один элемент, это целый плеер с кнопками, индикацией, полосой воспроизведения и регулировкой звука. Но где находятся эти кнопки и ползунки?
Верно — они живут в Shadow DOM, отдельной, «теневой» области, к которой по умолчанию нет доступа ни у разработчика, ни у кода.
Shadow DOM позволяет создавать сложные, составные компоненты, чья структура не видна «наружу». Благодаря «теневой» изоляции, любые изменения light DOM (обычного, «светлого» дерева) не коснутся содержимого такого компонента — не поедут стили, не заглючат скрипты.
Это, конечно, не самое полное объяснение, но суть раскрывает.
Сама идея выросла не на пустом месте. Браузерам требовалась скрытая разметка для собственных элементов: медиаплеера, ползунков, поля поиска. В WebKit внутренние shadow trees использовались для браузерных контролов ещё до появления самого API; в 2011 году разработчики уже обсуждали поддержку таких деревьев в инспекторе и перевод на них media elements. Google предложила сделать тот же механизм основой Web Components — набора средств для переиспользуемых веб-компонентов. Первый публичный Working Draft вышел 22 мая 2012 года.
Но тот Shadow DOM был не таким, как нынешний. Ранняя версия, позже названная v0, позволяла несколько теневых корней на одном хосте, распределяла содержимое через элементы <content> и <shadow> и имела собственные пронизывающие границу CSS-комбинаторы. Экспериментальная реализация из WebKit досталась Blink и там стала доступна авторам страниц, однако другие производители не захотели закреплять эту модель. После долгих споров в 2015 году WebKit предложил более простую схему со слотами, близкую к современной. Старые ::shadow и /deep/ сначала объявили устаревшими, а затем удалили из Chrome.
Стабильная межбраузерная история началась только после этого. Shadow DOM v1 появился в Chrome 53 в августе 2016 года; новый WebKit уже показывали в первой Safari Technology Preview весной того же года; Firefox включил Shadow DOM и Custom Elements по умолчанию лишь в версии 63, 23 октября 2018 года. Отдельную спецификацию Shadow DOM к тому моменту отправили в архив: её понятия и алгоритмы вошли прямо в живые стандарты DOM, HTML и CSS.
В то время, когда Opera Presto был закрыт, технология существовала только в виде пары ранних черновиков. Успей разработчики их реализовать — всю работу пришлось бы выбросить. Сейчас же можно посмотреть, к чему эволюционно пришли WebKit/Blink/Gecko: это явные области дерева и специализированные обходы в них.
XXX. Мнимая простота
Ладно, выглядит несложно. Описание технологии есть. Есть три разных примера того, как она уже сделана (скопировать их нельзя, но посмотреть принципы реализации можно). Есть готовый набор WPT для Shadow DOM.
Проблема в том, что это абсолютно новая сущность для Presto — и она огромная. Все прежние изменения были или относительно небольшими, или попросту расширяли заложенные в движок возможности.
Конечно, сначала я поискал хоть какие-то зацепки, и даже кое-что нашёл. Например, ShadowRoot в исходниках Opera всё-таки есть, но он абсолютно не тот, что нужен. Речь об SVG <use>; SVG тоже создаёт невидимое снаружи дерево, но делает это клонированием. Для Shadow DOM такой подход принципиально неверен. Узел, распределённый в <slot>, обязан сохранять идентичность; host.firstChild, event.target внутри своей области и объект, который уже держит скрипт, должны по-прежнему указывать на один и тот же узел.
Зато в старой архитектуре нашлись другие полезные заготовки. DOM_DocumentFragment уже владел отдельным физическим HE_DOC_ROOT. Печать, XSLT и тот же SVG приучили часть движка к существованию нескольких деревьев. HTML_Element умел получать редкие расширения в виде ComplexAttr, не увеличивая каждый элемент страницы. ElementRef сообщал владельцу об уничтожении узла. У CSS и layout были центральные места, через которые можно было провести новую семантику, не переписывая буквально всё.
Всего в коде больше тысячи вызовов семейства FirstChildActual, NextActual и других физических обходов. Глобально заменить их на «новый правильный обход» было бы не только непосильно, но и ошибочно: парсеру, сериализации, обычным DOM API и освобождению памяти как раз нужен старый физический порядок. Shadow DOM не отменяет исходное дерево, он добавляет несколько новых ответов на вопрос «кто чей ребёнок?».
Главное архитектурное решение можно сформулировать так: в реализации нет единственного «Shadow DOM-дерева». Есть четыре связанных представления, и ни одно нельзя безнаказанно подменить другим.
Физическое light tree        Что видят обычные DOM-обходы
Отдельное shadow tree        Внутренности конкретного ShadowRoot
Shadow-including tree        Связность, жизненный цикл, GC и общая иерархия областей
Flattened tree               Слоты, стили, layout, фокус и видимое представление
Первые два — настоящие физические деревья узлов; остальные вычисляются из них и из связей host–root и slot–assigned node. Сходным образом устроены современные браузеры, но встроить такую модель в Presto пришлось его собственными средствами.
Я уберегу вас от погружения в технические дебри, скажу только, что это было сложно, долго и масштабно. Вся реализация уместилась примерно в 18k строк, включая тесты и изменения в парсере CSS. Не всё прошло гладко, и, вероятно, реализация ещё содержит некоторые ошибки, не выловленные тестами. Изменения крайне инвазивные, затрагивающие почти каждую подсистему Presto — первые тесты показали это наглядно, вылетами в самых неожиданных местах. Также непонятно, как это отразилось на скорости работы браузера — замеры и оптимизации производительности пока что не в приоритете.
Поэтому я прибёг к возможности, о которой рассказывал в самом начале. Shadow DOM получил свой собственный compile-time переключатель FEATURE_SHADOW_DOM: движок можно собрать без теневого дерева, полностью сохранив старое поведение. Это первая подобная фича, добавленная с момента начала работы.
XXXI. Что дальше?
Теперь, когда у нас есть полноценный отладчик, можно натравливать браузер на сайт, смотреть, что конкретно не работает, и заниматься. Заниматься этим ещё рано, но фундамент теперь есть.
Основная точка приложения усилий — это, конечно, ECMAScript. Про бессмысленность существования браузера без современного JS сказано уже не раз. Потом — CSS. Попутно — многие API, на которые всё опирается.
Какое-то время браузер всё ещё будет выглядеть застрявшим в 2013 году. Но после того, как все основные функции будут реализованы, поддержка современного веба будет восстанавливаться очень быстро.