The Engine We Lost: Digital Archaeology of Opera Presto
Движок, который чему-то учится: современный JavaScript и древние баги Opera Presto
Оглавление
- XIII. Новый язык для старого Carakan
- XIV. Три смерти одной страницы
- XV. Схватка двух якодзун
- XVI. Как (и зачем) правильно притворяться
- XVII. Патчи для всего интернета и другие безумные находки
- XVIII. Что дальше?
В прошлый раз я остановился на том, что нам нужен ES2015. Без апгрейда Carakan (который прекрасно знает ECMAScript 5.1, но ничего не знает о более новых спецификациях) мы не только не сможем использовать современный веб — мы даже не запустим многие тесты.
Загвоздка тут в том, что JS-движки, как бы это сказать, сложные. Язык JavaScript рождался в муках, без всякого дизайна и получился таким, каким получился. С одной стороны, он имеет минимальный порог вхождения, с другой — он полон неоднозначностей, граничных условий и мозговыносящей логики. Ранние реализации постоянно расходились, и нередки были случаи, когда один и тот же код приходилось писать для разных браузеров по-разному.
Стандартизация была призвана решить хоть часть этих проблем и не допустить появление новых. Де-факто, это сработало, но стандарты закрепили родовые проблемы языка, и движку эти проблемы придётся решать.
XIII. Новый язык для старого Carakan
Движок языка — это парсер, промежуточное представление, интерпретатор, сборщик мусора, JIT под несколько архитектур, и всё это обязано согласованно реализовывать спецификацию, которая местами описывает наблюдаемые побочные эффекты с точностью до порядка обращений к свойствам.
И тут я не буду притворяться, что хоть что-то в этом понимаю. Напротив: я не знаю, как такие движки работают, и, тем более, как их писать. Разработчики, обладающие таким пониманием и опытом — это элита элит, штучные экземпляры (к которым я точно не отношусь), и это одна из причин, почему этих движков в браузерах существует только три (технически их, конечно, больше — существуют экспериментальные, исследовательские, любительские движки, проходящие Test262, и они также очень сложны).
Добавить в Carakan поддержку новой редакции языка я бы сам никогда не смог, и всю работу снова взяли на себя AI-агенты. Я только дал им фреймворк работы: пишется фича, прогоняются тесты, вторая модель проводит ревью, косяки исправляются, и так далее. Ровно то, что происходит в обычном процессе разработки, только раз в сто быстрее. Захватывающе и пугающе одновременно.
За неделю сделано:
- Классы с наследованием и
super. - Модули —
import/exportи<script type="module">. - Генераторы и весь протокол итерации, включая
for...of. - Блочная область видимости:
letиconst. - Стрелочные функции.
- Шаблонные строки.
- Деструктуризация, параметры по умолчанию, остаточные параметры, spread.
Symbol.Map,Set,WeakMap,WeakSet.Promise.- И сверху —
async/await, которые формально уже ES2017, но без них современный код не читается.
В цифрах: 66 160 добавленных строк в 581 файле, из них 40 175 — в самом Carakan. По тестам ECMAScript результат вырос с 30 282 до 49 789. По html5test — с 354 до 370 из 555.
Но главное тут не цифры. Раньше страница, подключившая современный скрипт, теряла его целиком: парсер останавливался на первой же стрелочной функции, и дальше не исполнялось ничего. Эти дополнения дали качественный переход: браузер перестал спотыкаться о синтаксис и начал спотыкаться о содержание. Это гораздо более выгодная позиция.
Две технические детали, которые показывают характер работы.
Часть новых конструкций намеренно оставлена без JIT-ускорения. Понятнее всего будет пример с генераторами. Обычная функция живёт на стеке: вызвали, отработала, вернулась. Генератор обязан остановиться посреди себя, отдать значение наружу, пережить возврат управления и потом продолжить с того же места — с целыми локальными переменными, недоделанными try и незакрытыми finally. JIT в Carakan умеет превращать код в машинные инструкции, но не умеет выразить функцию, которая останавливается посередине. Поэтому каждый генератор получает собственный контекст исполнения со своим стеком и работает интерпретатором. По той же причине мимо JIT проходят async-функции, обращения к new.target и функции с параметрами по умолчанию.
Список исключений JIT присутствовал в движке изначально. Например, оказалось, что JIT Carakan всегда игнорировал любую функцию, содержащую try/catch. Никаких документальных свидетельств причины этого не осталось, но тайна невелика: это очень сложно! Ранние JIT-компиляторы (включая гугловский V8) массово не умели оптимизировать функции с try/catch и try/finally (в V8 эта проблема называлась bailout reason: try catch statement). Исключения ломают граф потока управления, и писать JIT для них адски сложно. Так что решение не компилировать такие функции здесь не выглядит как белый флаг.
И я их понимаю. Сам я не хочу сейчас трогать JIT даже со всеми агентами — это, скорее всего, самая сложная часть браузера в принципе, и, к счастью, для работы не обязательная. Новая семантика реализована в парсере, байткоде и интерпретаторе; генератор машинного кода получает только необходимый минимум правок.
Другая деталь: соответствие старому стандарту ухудшилось. На каноническом наборе тестов для ES5.1 движок проходил 11 568 из 11 572, а теперь проходит 11 318. Дело в том, что ES2015 местами не дополняет предшественника, а отменяет его правила. Классический пример: в ES5.1 свойство length у функции обязано переживать удаление, а в ES2015 его сделали настраиваемым. Реализовать можно только одно поведение из двух, и смысла писать какой-то набор переключателей нет.
XIV. Три смерти одной страницы
Во время доработки Carakan постоянно всплывали неожиданные проблемы, казалось бы, вовсе не связанные с JavaScript. Напомню, движок умеет компилироваться и запускаться в standalone-режиме, и именно этот режим используется для тестирования. Тесты зелёные, но после полноценной сборки сам браузер падает.
Вот одна такая история с поиском по картинкам Яндекса — браузер стал умирать на странице в 100% случаев.
Начинается всё с того, что на странице происходит обыкновенная ошибка в скрипте. Ничего особенного, учитывая объём изменений, просто где-то что-то не сошлось. Браузер в такой ситуации должен написать в лог строчку вида «ошибка там-то, строка такая-то» и жить дальше.
Вместо этого он умирал, составляя эту самую строчку. Ошибка не появлялась, потому что падение было внутри механизма сообщения об ошибке.
Улика была одна — краш-лог, и в нём куски недособранной строки: \n\nError , ` line 1,, 203 in <`. Всё на первой строке, потому что скрипт минифицирован. Напрашивалась версия, что минифицированный файл слишком длинный: движок хранит позицию в исходнике в упакованном виде, с потолком, и она переполнилась. Версия оказалась неверной — при переполнении значение становится меньше, а меньшее всё ещё указывает внутрь файла.
Настоящая причина обнаружилась в стрелочных функциях. У записи x => expr нет тела с return, поэтому парсер сначала разбирает выражение, а потом подменяет его на конструкцию возврата — и при подмене теряет отметку о том, в каком месте файла это было.
Движок хранит позицию упакованной: два 32-битных слова, в которые втиснуты номер символа, номер строки и длина. Отдельного флага «позиция не задана» там не предусмотрено — вместо него все биты выставляются в 1. Функция, проверяющая это значение, в коде есть, но в этом месте вызывать её просто забыли.
Поэтому движок интерпретировал единицы как обычные числа и получил «символ номер 16 777 215» — максимум, который влезает в отведённые под номер символа 24 бита. После чего попробовал обратиться к этому символу в тридцатикилобайтном файле, и закономерно упал.
Починили — страница упала снова, теперь в сборщике мусора. Это худший вид падения: он происходит не в момент какого-либо действия, а когда сборщик обходит память и натыкается на ячейку, в которой лежит не то, что он ожидал.
Виновата оказалась проверка, которой движок отличает «в переменной лежит значение» от «в переменной лежит ссылка на настоящее хранилище». Проверка смотрела на служебный признак — а этот признак покрывает две разные вещи: и такие ссылки, и символы, новый тип данных из ES2015. Переменная с символом внутри, захваченная вложенной функцией, читалась как ссылка, и движок разыменовывал то, что ссылкой никогда не было. И вот здесь самое интересное: эта проверка приехала с оригинальными исходниками. Баг был недостижим ровно до тех пор, пока в переменной не мог оказаться символ. Символы появились, когда мы реализовали ES2015.
Починили и это — страница упала в третий раз, примерно на каждой третьей загрузке, и уже вообще не в JavaScript, а в сетевом кеше. Там браузер накапливает пришедшие байты в маленьком буфере и, когда данных становится много, переезжает в большой. При переезде счётчик «сколько накоплено» сохранял старое значение, а буфер под ним ужимался — и следующее копирование читало по счётчику из буфера, который стал короче. К нашей работе это отношения не имело вовсе: просто до этого места никто не доходил, потому что браузер умирал раньше.
Три разных последовательных исторических бага в трёх разных подсистемах, вскрытых тем, что теперь Carakan не падает на стрелочных функциях.
XV. Схватка двух якодзун
Прочтя предыдущие части, вы должны были задаться вопросом: если Opera была таким передовым браузером, то почему она проиграла?
Здесь есть соблазн упростить историю до «большая злая корпорация задавила маленькую независимую компанию». В чём-то это даже будет правдой, но история, как водится, всегда гораздо сложнее.
Представьте: начало 2000-х, полночь. Под столом успокаивающе шелестит пропеллер внутри бежевого корпуса вашего «Целерона», да похрустывает иногда десятигигабайтный винчестер. Все домашние уже уснули, и никто не отвлечёт вас от самого великого из всех удовольствий: интернета по ночному тарифу. Телефонная линия свободна, дозвон, коннект, 33.6 — и через пару минут на пузатом мониторе переливается гифками Интернет с большой буквы. И до утра — чаты, форумы, фанатские статьи о любимом сериале, прикольные картинки…
Но отриньте ностальгический флёр: пользоваться этим было очень неудобно. Вашим браузером в 99% случаев был Internet Explorer 6.0 (а то и 5.0), вся парадигма которого предполагала просто окно с тем, что туда загрузилось, плюс несколько кнопок простейшей навигации. «Осёл», он же «ишак», с пользовательской точки зрения, был неудобным, неотзывчивым и очень своенравным — но зато он всегда был в системе. Существовали надстройки, вроде Maxthon и Avant Browser, они решали часть проблем с удобством (добавляя, например, вкладки), но всё ещё были медленными.
Был ещё и Netscape Navigator — «нетшкаф». Про него сейчас принято вспоминать с большей теплотой, но, честно говоря, по пользовательскому опыту разницы с IE у него было мало. Да, он был лучше — но его где-то надо было достать; NN 4.5+ — это пятнадцать мегабайт инсталлятора, которые нужно качать всю ночь, а то и две, и которые потом будут занимать драгоценное место на диске. С таким раскладом было проще посидеть на IE. Ну, разве что инсталлятор попадётся на очередном диске, приложенном к «ксакепу», «компьютерре» или даже «game.exe» — тогда можно поставить вторым браузером.
Но однажды на таком вот диске вам попадается что-то новое и интересное. Opera 4, 1.8 мегабайта, и это работает с какой-то невероятной отзывчивостью и удобством. Я помню, что читал фанатские переводы «Гарри Поттера» в IE, и это было на грани терпимости. Каждый скролл страницы занимал секунды, а выставлять странице нужный масштаб «ишак» просто не умел. Opera делала это моментально.
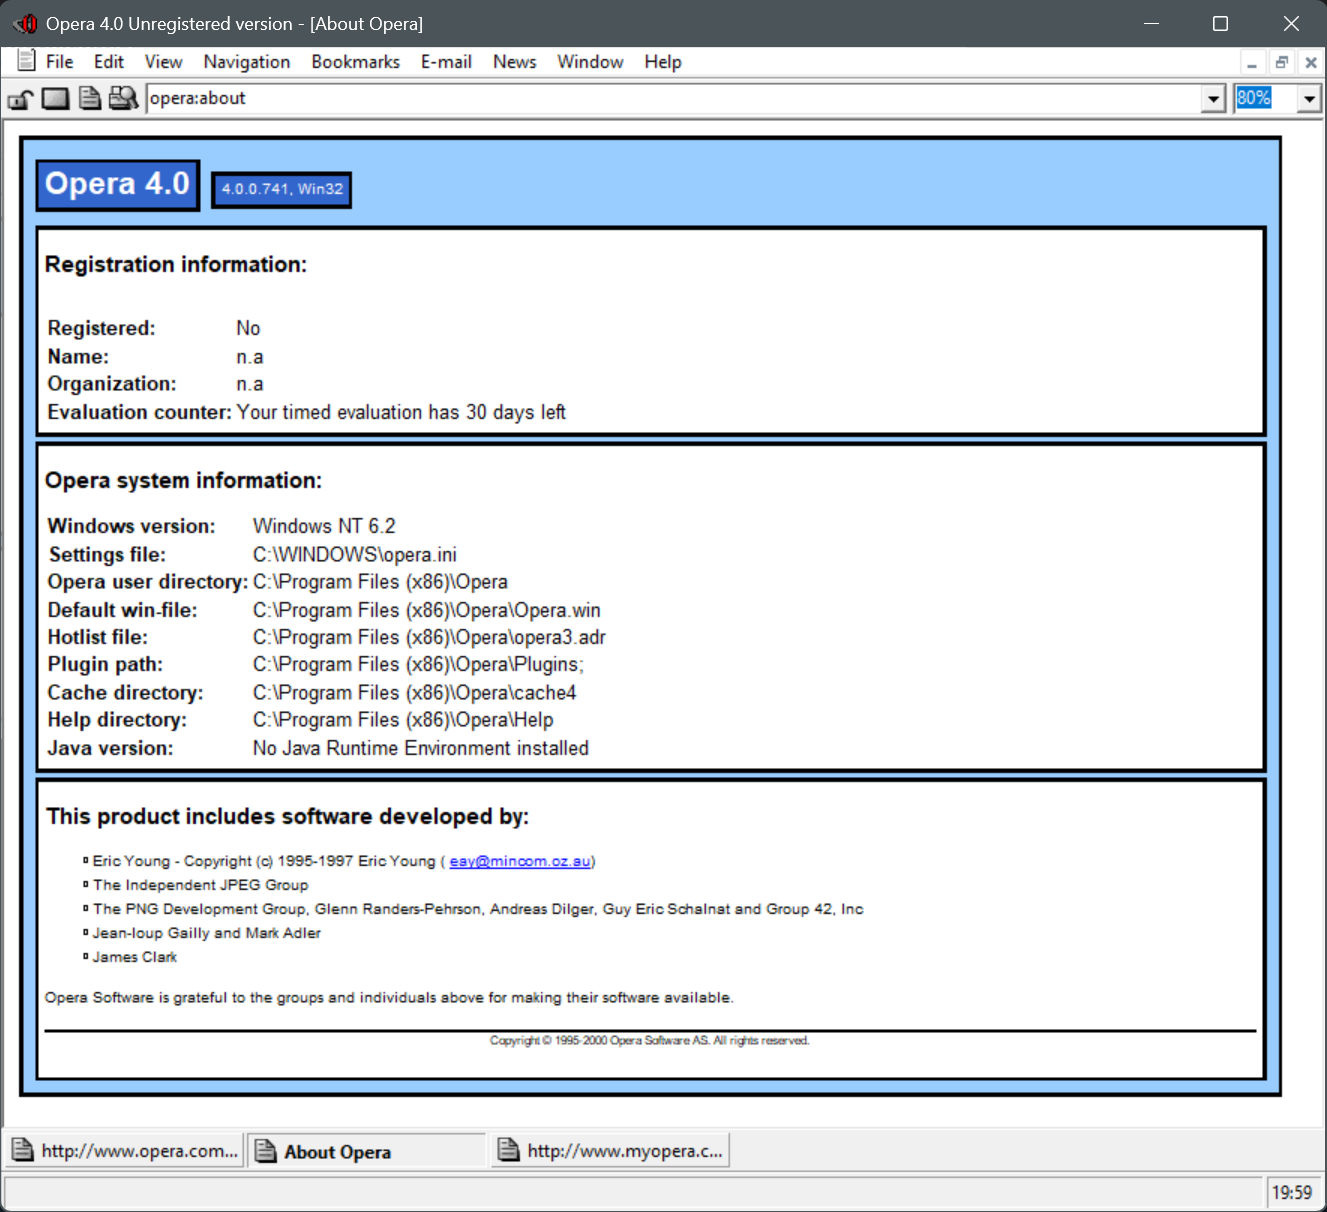
Opera была платным продуктом, какие-то версии имели ограниченный срок годности, какие-то показывали неотключаемый баннер. Если вы, как и я, жили в России, то купить программу у вас не было ни денег, ни возможности — и необходимость искать «кряк» никого не смущала абсолютно.
Возможно, это и была одна из причин, почему Opera прижилась на территории постсоюза. Я могу предположить, что в иной обстановке я бы задумался над выбором между бесплатным, но неудобным продуктом, или платной альтернативой. В ситуации, когда весь твой софт по умолчанию был ворованный, дилемма не возникала.
Так или иначе, в странах СНГ Опера была хитом. В лучшие годы десктопная версия браузера занимала 50% рынка в некоторых из них. А вот мировая статистика была на порядок хуже — не больше 5% в пике. Уточню, что речь именно о десктопных версиях, с мобильным рынком ситуация иная, Opera Mobile и Opera Mini в совокупности занимали четверть постоянно растущего рынка.
В сентябре 2005 года браузер сменил модель монетизации, став полностью бесплатным для пользователя и начав продавать свою популярность. Году этак в 2007 ситуация выглядела так: есть IE, он абсолютно ужасный во всех смыслах, но он предустановлен вместе с Windows, и занимает 80% рынка. Есть Safari, это если у вас «мак». И есть Firefox с Opera — вот это два настоящих, трушных браузера, со своей небольшой, но преданной аудиторией.
Но почему их аудитория не росла? Я не готов браться за всесторонний анализ, но вот как картина выглядит с моей точки зрения.
Если вам в то время приходилось верстать страницы, то знаете, что заказчик обязательно требовал «чтобы в Internet Explorer работало» — и имелся в виду обычно Internet Explorer 6.0. Неважно, насколько он был крив, насколько плохо он поддерживал удобные фичи — все силы уходили на него. Затем отдельная поддержка делалась для Firefox — он уверенно держал второе место, у него был абсолютно имбовый Firebug, так что разработчики его любили. Остальное делалось по остаточному принципу; поддержку Safari заказчик ещё мог потребовать, а с Оперой заморачивались редко.
В итоге, пользователь, решивший попробовать альтернативный браузер, нередко сталкивался с тем, что страницы выглядели «неправильно» — хотя проблема могла быть не в браузере, а в странице. Разработчики из Opera Software отслеживали и вручную чинили такие случаи — где-то кодом, где-то с помощью внешнего набора скриптов совместимости (это очень интересный механизм, о котором я расскажу ниже), и в новых версиях проблемы решались. Но вот только пользователь уже не возвращался.
Иногда случалось так, что сайты специально подсовывали Опере полностью альтернативное содержимое — из благих ли побуждений, или из вредности. Упрощённая верстка, сломанные скрипты — да кто будет напрягаться ради маленькой аудитории.
В Опере даже ввели механизм спуфинга UserAgent, т.е. браузеру приходилось специально притворяться чем-то другим. Сайт видел не Opera, а, скажем, Internet Explorer, и в большинстве случаев всё работало.
Но это вело к тому, что видимая доля использования Оперы уменьшалась! А раз так — всё меньше разработчиков заботилось о проверке и доработке своих сайтов. Опера на десктопе попала в лимб, и так из него никогда и не выбралась.
Появление Chrome в 2008 году воспринималось как невероятно позитивный факт. Сама идея об абсолютно новом, быстром, удобном и открытом браузере вызывала восторг. Google тогда был корпорацией добра, действительно развивающей интернет, и казалось, что так будет всегда. Они не собирались конкурировать с Opera Software ASA — их доля была слишком мелка для мегакорпорации. Это была конкуренция за мировое господство в болоте, которое много лет никто не мог расшевелить.
Результаты мы знаем. Microsoft попытались в конкуренцию, выпустили ещё несколько версий IE, но проиграли и приняли поражение. В Mozilla, жившей на контрактах с Google, забили на Firefox, вместо этого выбросив уйму ресурсов на мертворождённую Firefox OS. Chrome стал новым IE, а маленькую Оперу просто смыло волной, поднявшейся в результате схватки двух якодзун.
XVI. Как (и зачем) правильно притворяться
Я не просто так поддался ностальгии. Упомянутый в этой истории механизм подмены Identity актуален и по сию пору. Куча сайтов, если зайти на них со старым UA Оперы, в лучшем случае предупредят вас, что браузер устарел. В худшем случае — выдадут страницу ошибки — этим, например, грешит поиск Google. При этом так он себя ведёт только с Opera — стоит сменить UserAgent на Firefox, ошибка тут же исчезает.
Поразительно. Страницы, которые вообще никогда не могли быть открыты в браузере, мёртвом уже столько лет, до сих пор обеспокоены его существованием. Google делал так пятнадцать лет назад и делает это до сих пор.
Чтобы обойти это, потребовалось две дополняющих друг друга доработки.
Взглянем на текущий UA:
Opera/9.80 (X11; Linux x86_64) Presto/2.12.388 Version/12.15
это хорошая иллюстрация того, из какой чуши состоят UA всех браузеров. 9.80 здесь — это не какой-то кодовый идентификатор и не ошибка, это специально оставлено так. Видите ли, сайты сравнивали версию браузера как строку, а значит "9.8" > "10.00". Правильную версию пришлось добавлять отдельным включением; агентские строки современных браузеров состоят из такого чуть менее, чем полностью.
Но что в этом для нас?
Во-первых, нам нужно избавиться от идентификатора Opera. Этот товарный знак нам не принадлежит, а сам токен заставляет сайты выдавать предупреждения. По своим внутренним соображениям я решил использовать латинское слово Otium (многозначный термин, который можно перевести, как «праздность»), как полный антоним латинского же значения слова Opera («труд»).
Теперь браузер представляется так:
Otium/2026.7 (X11; Linux x86_64) Presto/2.13.0
Кроме UA пришлось исправить и иную логику, по которой осуществляется распознавание браузера (navigator.appName, navigator.appVersion и т.п.; на window.opera рука у меня не поднялась).
Во-вторых, был переработан механизм маскировки. Изначально он прост: в браузер вшит статический список юзерагентов, и каждому отдельному домену можно указать свой, но изменять сам список нельзя.
Теперь идентификация полностью настраивается — в набор конфигов добавлен identity.ini, и теперь все подмены берутся из него.
XVII. Патчи для всего интернета и другие безумные находки
Самое время рассказать о browser.js — механизме, с помощью которого в Opera чинили чужие сайты в своём браузере.
Сам механизм довольно прост: в поставке браузера было несколько файлов browser.js (каждый для своего региона), содержащих патчи для сайтов. Эти патчи прозрачно для пользователя подгружались в контекст, и делали ту работу, которую веб-мастер посчитал необязательной.
Каков размах! А какова идея?! Механизм явно появился не от хорошей жизни, и хотя патчить приходилось далеко не весь интернет, самые востребованные сайты того времени дорабатывались. Capital One, E*TRADE, Expedia, AOL, IBM, Amazon, Yahoo Japan, AT&T, T-Online, Asahi, Baidu, Wimbledon — места, на которых сломанная страница стоила пользователю нервов и денег.
Браузер постоянно получал обновления этих патчей с серверов Opera. Для защиты от подмены файлы подписывались: b64-кодированная подпись находится в комментарии на первой строке. В бинарнике Оперы вшит открытый RSA-2048, по которому проверяется подпись, и если файл был изменён, функция отключалась.
Но иногда browser.js было недостаточно, чтобы починить сломанный веб. Сайты писались криво, потому что кривые браузеры это позволяли, и инженерам Opera приходилось иногда отступать от стандартов (modules/style/src/css_selector.cpp:721):
// Case sensitive id selectors in strict mode (according to spec.)
// Case insensitive in quirks mode (like IE).
// rune@opera.com 2002-12-03
#MyId и #myid становились одним селектором, если страница была в режиме совместимости, потому что IE так делал.
Иногда к движку прибивались гвоздями хаки под конкретные сайты. Вот комментарий к коду расчёта размеров iframe для маленьких экранов (modules/layout/content/content.cpp:10013):
/* CSSR - page designers (read gmail) may choose to position the iframe outside
   the screen, to make it invisible, but still make sure it loads. This hack
   makes sure it gets hidden in this case. */
«Дизайнеры страниц (читай: gmail)». Отрицательное позиционирование за пределы экрана как способ спрятать загружающийся iframe — и целая ветка в движке, чтобы такой iframe не растянулся на весь экран в мобильном режиме.
Какая знакомая боль.
Вообще в Opera частенько прибегали к встраиванию всяких проверок. В modules/rootstore/extra/untrusted/ лежит куча заголовочных файлов, содержащих известные скомпрометированные сертификаты байт в байт. Список того, что там хранится, читается как хронология всех крупных провалов инфраструктуры доверия:
UNTRUSTED_BASE_ENTRY(FAKE_MS_OBJECTSIGN_1, NULL, "Fraudulent certificate, NOT Microsoft" )
UNTRUSTED_BASE_ENTRY(NUL_INNAME_CERT_1,  NULL, "Fraudulent certificate, uses format that can trick user agents into accepting certificate for wrong host" )
UNTRUSTED_BASE_ENTRY(ROGUE_01_2009, NULL, "Fake intermediate CA certificate created using MD5 signature collisions")
UNTRUSTED_BASE_ENTRY(UNTRUSTED_COMODO_2011_03_01, NULL, "Fraudulent certificate. Not the identified site")
UNTRUSTED_BASE_ENTRY_RANGE(DIGINOTAR_2007, NULL, "Untrusted due to being hacked and having issued an unknown number of fraudulent certificates",2,0,2,2),
Поддельные сертификаты подписи кода «от Microsoft» (2001), сертификаты с нулевым байтом в имени из атаки Мокси Марлинспайка (2009), демонстрационный промежуточный УЦ, собранный на коллизиях MD5, взломанный DigiNotar, утекшие сертификаты Comodo и прочее.
Этот механизм дополнялся обновлениями через certs.opera.com. Документация не объясняет, почему некоторые сертификаты нужно было проверять «на месте», но рассказывает, что инструмент создания отпечатков валидации называется EViL-bot (The Extended Validation internal Logistics Bot).
XVIII. Что дальше?
Каждое вносимое исправление открывает десяток новых необходимых доработок, и конца-края этому не видно. Это захватывающе и ужасно одновременно. К счастью, AI-агенты не склонны к выгоранию.
30 августа 1995 года Йон Стефенсон фон Течнер и Гейр Иварсёй создали компанию Opera Software, и этот день считается «днём рождения» Opera.
30 августа 2026 года наступит через месяц с того момента, как я это пишу. Я бы хотел, чтобы «оживлённая» Опера к этому дню была способна работать с современным вебом. Это очень широкое требование, и я понятия не имею, выполнимо ли оно вообще.
Но кто запретит пытаться?