The Engine We Lost: Digital Archaeology of Opera Presto
Движок, который снова научился гуглить
Оглавление
- XXXII. Fetch для Opera Presto
- XXXIII. Один движок, две СУБД
- XXXIV. Айсберг IndexedDB и судьба Web SQL
- XXXV. Что дальше?
XXXII. Fetch для Opera Presto
Возьмите последний официальный релиз Opera Presto и попытайтесь в нём погуглить. Абсолютно базовая операция — кажется, она могла бы работать и в более древних браузерах. Однако даже если вы прорвались через предупреждения безопасности и подменили UA, вы увидите только сообщение об ошибке. За ним скрыта необходимость в Fetch.
Погрузимся в историю.
До Fetch веб-разработчики пользовались XMLHttpRequest, или XHR. Интерфейс придумали в Microsoft, затем его переняли остальные браузеры, а вокруг него выросла вся эпоха AJAX: страницы научились обращаться к серверу и обновлять своё содержимое без полной перезагрузки. Спецификация XHR несёт в себе оперовский след: её редактором был Anne van Kesteren из Opera Software, позднее ставший автором Fetch Standard.
XHR оказался чрезвычайно живучим, но красивым его я не назову. Один объект одновременно хранит параметры запроса, принимает ответ, меняет внутренние состояния и рассылает события. Нужно создать его, вызвать open(), навесить обработчики, вызвать send(), следить за readyState и отдельно решать, какое состояние уже можно считать ответом. Интерфейс складывался постепенно, пережил несколько итераций и прекрасно отражает эпоху, когда асинхронный JavaScript состоял из коллбеков.
Fetch появился не только как «удобный XHR». Его задача шире: дать веб-платформе единое представление о запросе, ответе, заголовках, теле, перенаправлениях и доступе к чужому домену. Ведь ресурсы загружает не только JavaScript, это делают HTML, CSS, шрифты, воркеры, медиаплеер и ещё десятки API, и исторически каждый из них обрастал собственными правилами. Fetch Standard попытался описать одну общую машину загрузки, а функция fetch() стала её видимой для разработчика частью.
И снова знакомая ситуация: на момент заморозки Opera Presto работа над Fetch велась, но была далека даже от чернового варианта. Первый набросок Fetch API появился 27 мая 2014 года, Chrome и Firefox поддержали его в 2015-м, Safari добрался до него только в 2017-м.
Ну а в настоящий момент технология стала абсолютно базовой, и на этот вызов завязана работа кучи библиотек и сервисов. Без fetch() вы даже погуглить не сможете. Именно поэтому после появления в Carakan Promise и async/await Fetch стал одной из самых очевидных и критических доработок.
XXXII.I Ложная простота Fetch
Вынырнем обратно в современность.
Когда браузеру показывают <img>, <script> или ссылку на таблицу стилей, он прекрасно знает, что делать: собрать HTTP-запрос, найти ресурс в кеше или сходить за ним в сеть, разобраться с перенаправлениями, куками и сертификатами, а затем передать полученные байты нужной подсистеме. Поэтому современная функция fetch() выглядит почти оскорбительно просто:
const response = await fetch("/api/news");
const news = await response.json();
Дайте браузеру адрес, дождитесь ответа, прочитайте из него JSON. Казалось бы, в движке, который уже всё это делает, на реализацию такого API должно уйти полчаса. Можно даже взять уже существующий XMLHttpRequest, завернуть его в Promise и объявить работу законченной.
Можно — но нельзя.
Да, XHR и Fetch используют одни и те же функции браузера. DNS, соединения, прокси, TLS, cookies, HTTP-аутентификация и дисковый кеш у них общие. Различается то, как браузер описывает операцию, управляет ею и показывает результат JavaScript-коду.
| XHR | Fetch | |
|---|---|---|
| Основная сущность | Один изменяемый объект-запрос | Значения Request и Response плюс одноразовый контроллер операции |
| Настройка | open(), затем заголовки, responseType, timeout, затем send() |
Все параметры собираются в снимок Request до начала загрузки |
| Результат | Записывается обратно в тот же XHR-объект | Создаётся отдельный Response |
| Асинхронность | Состояния и события | Promise |
| Получение данных | responseText, response, responseXML |
text(), json(), blob(), arrayBuffer(), formData() |
| Повторное чтение | Обычно возможно | Тело одноразовое: после чтения устанавливается bodyUsed; для второго потребителя нужен clone() |
| Прогресс | Есть upload/download progress events | Нет событий прогресса |
| Отмена | xhr.abort() |
Внешний AbortSignal, который можно передавать нескольким операциям |
| Таймаут | Встроенное свойство timeout |
Обычно таймер плюс AbortController |
| Синхронный режим | Исторически существует | Принципиально отсутствует |
XHR устроен как небольшой автомат. Вызов open() переводит его из UNSENT в OPENED, получение заголовков — в HEADERS_RECEIVED, поступление тела — в LOADING, окончание — в DONE. На каждом этапе браузер меняет поля того же объекта и посылает readystatechange, progress, load, error, timeout или abort. Объект можно сбросить новым open() и использовать заново.
Fetch же рассматривает загрузку как преобразование:
Request → сетевая операция → Response
Request содержит метод, URL, заголовки, тело и политики безопасности. После запуска они уже не должны незаметно меняться. Внутренний DOM_FetchController живёт ровно одну операцию, а по её завершении исполняет или отклоняет Promise и уничтожается. Полученный Response существует независимо от контроллера.
Особенно сильно отличается модель безопасности. У XHR есть same-origin/CORS и withCredentials, но нет ответа, который бы «был получен, однако его содержимое запрещено видеть». Fetch вводит явные режимы same-origin, cors и no-cors, политики credentials и redirects, а также типы ответа basic, cors, opaque и opaqueredirect. Например, no-cors может разрешить отправить запрос, но вернуть opaque response, у которого скрипт не увидит ни статус, ни заголовки, ни тело. Для XHR неуспешная CORS-проверка просто выглядит как сетевая ошибка.
Ошибки у них тоже представлены по-разному. При сетевой ошибке XHR получает status == 0 и событие error, а Fetch отклоняет Promise. Но HTTP 404 или 500 не являются сетевой ошибкой ни для одного API: Fetch возвращает обычный Response с ok == false, а XHR заканчивается событием load и соответствующим status.
Поэтому Fetch нельзя реализовать как JavaScript-wrapper над XHR. У них общий низкоуровневый транспорт, но несовместимые жизненный цикл, правила доступа к ответу, обработка redirects, модель отмены и порядок выполнения JavaScript. В Presto мы повторно использовали сетевые кирпичи XHR — DOM_HTTPRequest, URL loader, CORS manager, cookies и redirect machinery, — но построили над ними отдельный DOM_FetchController.
XMLHttpRequest → DOM_XMLHttpRequest → DOM_HTTPRequest → URL/HTTP/TLS/cache
fetch()        → DOM_FetchController → DOM_HTTPRequest → URL/HTTP/TLS/cache
XXXII.II Вынужденные компромиссы
При реализации мне пришлось пойти на два компромисса.
Современный Fetch связан с Readable Streams. В нормальной реализации Promise от fetch() выполняется после получения заголовков, а тело можно читать кусками по мере прихода из сети. Это важно для больших файлов, потоковых протоколов и обработки данных без огромного промежуточного буфера.
В Presto Readable Streams нет. Streams API висит в бэклоге и когда-нибудь дождётся своего часа. Пока же реализация Fetch намеренно буферизованная. Opera целиком получает тело ответа, сохраняет байты и только потом отдаёт Response. Все методы работают асинхронно, но свойства Request.body и Response.body возвращают null: потока за ними действительно нет.
Из-за этого ждать ответа приходится дольше, запросы расходуют больше памяти, а потому такой Fetch не годится для потокового видео, гигантской выгрузки или построчного разбора бесконечного ответа. Зато он работает, и внутреннее представление разделено так, чтобы позже к нему можно было присоединить настоящий Stream, не выбрасывая Request и Response целиком.
Представьте страницу, которая одновременно дважды обращается к /account. Первый запрос обычный: браузер посылает сохранённые куки, и сервер узнаёт пользователя. Второй должен быть анонимным: параметр credentials: "omit" прямо запрещает отправлять куки и данные HTTP-аутентификации. Адрес один, но требования к двум запросам противоположные.
Opera к такому случаю не готова. Класс URL_Rep внутри движка — это суперобъект адреса. К нему привязаны загрузки, кеши, история и многое другое. Если две картинки на странице ссылаются на один и тот же файл, разумно найти его один раз и не скачивать повторно. Поэтому обращения к одному адресу во многих случаях сходятся на одном таком внутреннем суперобъекте.
Для картинок это прекрасная оптимизация. Для Fetch — потенциальная проблема. Если записать правило «посылать куки» в общий объект адреса, второй запрос может перезаписать настройку первого. Тогда анонимный запрос внезапно уйдёт вместе с куками или, наоборот, обычный запрос потеряет авторизацию. Результат будет зависеть от того, какой из двух запросов ушёл последним — а это непросто выяснить даже в однопоточном Presto, после того, как в Carakan появились планировщики для асинхронности.
Поэтому подобные моменты учитывались ещё при проектировании и проверялись на самых первых этапах реализации. В этом конкретном случае ожидаемый баг никак не хотел воспроизводиться, и вот это уже было странно.
Пришлось размотать всю цепочку вызовов от DOM_HTTPRequest::GetURL(). Сначала это выглядело так, будто добавление любого пользовательского заголовка к вызову меняет его identity во внутреннем представлении Opera, — а Fetch как раз добавлял заголовок Accept. Решение выглядит как случайность, если не вспомнить, что движок проектировали люди, которые прекрасно знали, что делали.
Спускаемся на уровень ниже. Все посещённые адреса хранятся в реестре Url_Store, и при открытии Url всегда проверяется, что у браузера уже есть для этого адреса. И вот тут случается неслучайность: если у входящего запроса есть какие-то нестандартные параметры, такой URL_Rep помечается уникальным, и следующие обращения к его адресу идут мимо реестра, кешей и истории.
Однако потенциальная проблема с примером выше всё ещё есть. Добавление упомянутого заголовка при вызове fetch() технически было необязательным (DOM_HTTPRequest::GetURL() добавляет Accept: */* самостоятельно), просто так получилось при первоначальной реализации. Позже этот код мог бы быть убран, и адреса в реестре стали бы сходиться на одном URL_Rep.
В качестве защиты все Url, запрашиваемые через Fetch, теперь сразу идут с флагом уникальности. К сожалению, это лишает любые такие запросы кеширования, но как это обойти — я подумаю в следующий раз.
XXXII.III Двадцать первый редирект
Если помните, мы уже сталкивались со случаями, когда новый код вскрывал старые баги?
Один из тестов WPT отправляет браузер по цепочке перенаправлений. Стандарт разрешает пройти не более двадцати редиректов; на двадцать первом fetch() должен отказаться продолжать и вернуть ошибку. Opera вместо этого падала.
Причина нашлась в старом сетевом коде. Прекращая загрузку, он уничтожал объект ресурса прямо в тот момент, когда его ещё обрабатывала сетевая функция. Сам обработчик должен был удалиться немного позже, после выхода из функции, но до этого успевал получить ещё одно сообщение и обратиться к уже уничтоженному ресурсу.
Fetch впервые воспроизвёл нужную последовательность событий. Ошибка могла лежать там много лет, потому что старые способы загрузки не доходили до этого состояния.
Исправление оказалось простым: не разбирать загрузку на части, пока выполняется её собственный обработчик.
XXXII.IV Что теперь умеет Opera?
Ну, теперь она умеет гуглить.
Уровнем ниже это значит, что теперь доступны fetch(), Headers, Request, Response, AbortController, AbortSignal и URLSearchParams в окне, выделенных и разделяемых воркерах. Можно выполнять запросы HTTP и HTTPS, загружать data: и blob: URL, передавать распространённые виды тел, читать ответы как текст, JSON, форму, Blob или массив байтов, клонировать неиспользованные запросы и ответы, отменять операции, управлять credentials и режимами перенаправления. Работают same-origin, CORS и безопасно ограниченный no-cors; непрозрачный ответ остаётся действительно непрозрачным.
Это ещё не значит, что реализован весь современный Fetch Standard. Нет Readable Streams, Service Workers и Cache API; нет перехвата запросов и фонового выполнения, потоковой отправки и загрузки, keepalive, Subresource Integrity и нескольких современных политик. Часть параметров Request распознаётся, но отклоняется, потому что движок не способен выполнить ожидаемое поведение. Работа ещё далека от завершения, но сделанное уже делает Opera гораздо более работоспособной.
XXXIII. Один движок, две СУБД
Я уже упоминал, что в Opera реализовали свой полнотекстовый поиск по всей истории посещённых страниц. Очень крутое решение, у которого почему-то нет крутого названия. Это просто Search engine — микро-СУБД на B-деревьях, сжатом индексе и специализированных структурах данных.
Однако в Presto используется и SQLite (на момент заморозки это была версия 3.7.9, бампнутая нами до 3.53.3), поддерживающий полнотекстовый поиск. Мы уже не раз видели, что в Opera делали свои решения, когда считали это нужным, но легко переходили на чужие, если это давало преимущество. Наличие двух СУБД, пересекающихся по возможностям, вызывает вопрос, с которым будет интересно разобраться.
XXXIII.I Изобретение Search engine
С модулем search_engine всё довольно просто: его автор оставил прямо в исходниках полноценную презентацию продукта. Модуль не является реляционной СУБД и не имеет SQL, схем, планировщика запросов или универсальной системы вторичных индексов. Его сильная сторона — несколько структур, заранее подобранных под конкретные операции Opera:
BlockStorageхранит записи в блоках, связывает записи произвольной длины, ведёт список свободных блоков, поддерживает журнал, откат, несколько режимов надёжности, предварительное журналирование и групповой commit нескольких файлов.BSCacheкеширует ветви поверхBlockStorage.SingleBTreeи связанные классы дают упорядоченный индекс для ключей фиксированного типа: чисел, дат и компактных структур.ACT(Array Compacted Trie) индексирует строки переменной длины и поддерживает точный и префиксный поиск.BSCursorдобавляет табличную запись из полей поверх блочного хранилища.StringTableсвязывает словарь ACT с posting lists в B-деревьях и выполняет полнотекстовый поиск.WordSegmenterзнает URL и e-mail, европейские и некоторые другие письменности, а для CJK использует n-граммы.VisitedSearchиRankIndexстроят инвертированный индекс посещённых документов, ранжируют результаты, сортируют по времени, поддерживают поиск по префиксу и фразе и хранят данные для текста результата, выдержек и миниатюр.UniCompressor— собственное быстрое сжатие UTF-16, рассчитанное на характерные для истории и почты строки.
Это очень конкретный инструмент, используемый в очень конкретных местах: при поиске по истории страниц и в содержимом почтовых ящиков в клиенте M2. Он спроектирован для работы с малым объёмом памяти и ограниченными временными бюджетами: быстрый запуск, краткие, но частые вставки и удаления. Вся механика подогнана под ожидаемый поток операций и цикл событий браузера, и, конечно, написана в «оперовской» парадигме.
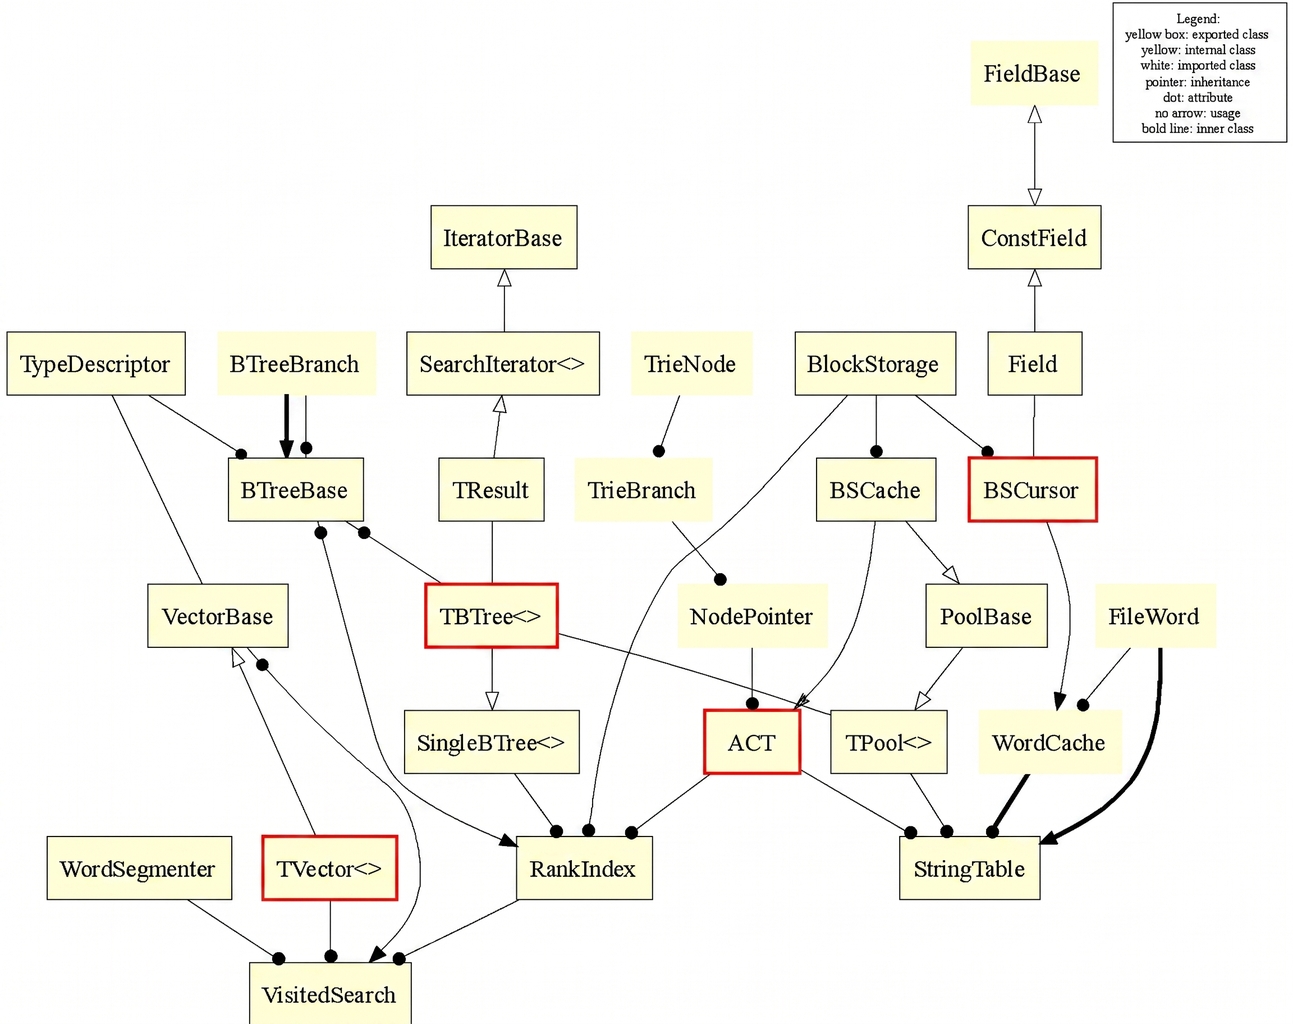
И это — 2006 год.
Наверняка другие решения хотя бы рассматривались. Если мы попробуем с высоты времён посмотреть, что тогда существовало в сегменте FTS, то увидим такой набор:
- Apache Lucene, Java-библиотека, поверх которой потом появился Elasticsearch. Технически Opera могла запускать Java-код, но вы и сами можете представить, как кривились лица инженеров Opera от такой мысли.
- Sphinx. Крутой, открытый и, на 2006 год, известный движок на C++.
- Xapian. Вторая настоящая альтернатива — открытая лицензия и C++.
Варианты FTS в «больших» базах данных рассматривать не имеет смысла. В маленьком и встраиваемом SQLite FTS1 и FTS2 только-только появились, и у них были явные проблемы производительности.
Но почему же не Sphinx/Xapian, неужели NIH-синдром?
Для начала перестанем держаться за дату. 2006 год — это год, когда Search engine уже появился и работал, а само решение явно принималось раньше — в 2005, а то и в 2004 году. Sphinx тогда существовал в зачаточном виде, да и спроектирован он как клиент-серверное решение. На этом рассмотрение можно заканчивать, хотя нашлись бы и другие причины отказа.
Xapian — гораздо более интересный случай. Уже его предок Muscat имел опыт поиска по сотням миллионов веб-страниц. Это библиотека, а не обязательно отдельный сервер; если бы я составлял шорт-лист кандидатов, то Xapian туда попал бы. Но — открытая лицензия открытой лицензии рознь. Xapian лицензируется под GPLv2+, что фактически запрещает его интеграцию в закрытом приложении. На этом тоже можно остановиться и не вспоминать, что стабильная версия Xapian 1.0 появилась только в 2007 году, и ей всё равно требовался бы значительный адаптационный слой.
Отсюда — совершенно очевидное решение: ничего подходящего нет, нужно делать своё.
Ну, они и сделали.
XXXIII.II Зачем SQLite?
Вот у вас есть своя шикарная СУБД. Зачем тогда понадобился SQLite?
Для Web SQL.
О нём у меня найдётся поучительная история. Сама идея дать веб-разработчикам SQL-подобный интерфейс словно витала в воздухе, и в 2008 году Apple добавила это API в Safari. Chrome и Opera добавили его в 2010 году.
Как проще и быстрее всего добавить к себе в браузер поддержку SQL? Взять SQLite, это же очевидно! Так сделали в Apple, так сделали в Chrome, и так, последними из всех, сделали в Opera.
А в Mozilla и Microsoft не сделали. Они вообще отказались внедрять стандарт, хоть и по разным причинам.
В Mozilla Foundation настаивали на том, что «очевидный путь» нарушает правило W3C: «чтобы черновик стал веб-стандартом, в мире должно существовать минимум две независимые реализации этой технологии». Когда все браузеры используют одно и то же решение, это решение и превращается в стандарт, вместе со своими особенностями и багами. Если кто-то потом пытается написать своё, альтернативное решение, ему придётся воспроизводить эти баги и особенности точь-в-точь.
Позиция Microsoft же заключалась в том, что единого стандарта SQL де-факто не существует. Да, как бы есть ANSI SQL, но каждая СУБД поддерживает что-то своё — T-SQL, PL/SQL, MySQL, PostgreSQL… У Microsoft существовал свой SQL Server, и внедрение в Internet Explorer «чужого» диалекта SQLite уязвило бы их гордость.
В Mozilla и в Microsoft посчитали, что вебу нужна не реляционная SQL-база, а низкоуровневое объектное хранилище (NoSQL). В таком хранилище можно было бы описать строгий стандарт (какие методы есть, как работают индексы), не привязываясь к парсингу сложных текстовых SQL-запросов. Веб-разработчики сильно их за это ругали: им казалось, что из-за бюрократии и упрямства этих корпораций их лишают удобного инструмента, заставляя переходить на сложный, асинхронный и непривычный IndexedDB.
Так или иначе, по формальным правилам W3C Mozilla и Microsoft были правы. 18 ноября 2010 года спецификация Web SQL была объявлена устаревшей и больше не развивающейся.
Удалили ли тогда Web SQL остальные браузеры? Конечно же нет.
Стандарт так прижился (особенно в веб-приложениях на iOS), что удалять его одним махом было просто опасно, и его держали включённым ещё долгие годы. В Safari удалили поддержку только в сентябре 2019 года, а в Chrome — так и вовсе в октябре 2023. Ну а Opera так и умерла с включённой поддержкой стандарта.
Web SQL никуда не делся даже сейчас. С помощью WASM можно скомпилировать SQLite прямо в браузере, используя IndexedDB или OPFS в качестве хранилища. Звучит одновременно и как магия, и как невиданный набор костылей, но это тот случай, когда «волшебные костыли» стали стандартным решением, поддерживаемым и со стороны SQLite, и со стороны браузеров.
XXXIII.III Нет, но всё-таки?
Но я не ответил на вопрос. У вас есть одна отличная СУБД, зачем вам ещё вторая? Они же явно пересекаются по возможностям, и логично бы было удалить одну из них, доработав при необходимости вторую.
В самом деле: в них обеих есть страницы или блоки, кеширование, B-деревья, выделение и повторное использование места, транзакции, журналы и обработка повреждений. Могли ли в Opera добавить SQL поверх Search engine?
Здесь я ступаю на зыбкую почву догадок. Представим инженера Opera, которому поручено реализовать новый стандарт. Ну как — новый; в Safari он уже есть пару лет, но Safari не в счёт, потому что там Web SQL нужен для веб-приложений. Но вот теперь стандарт заявлен и в Chrome, значит и нам пора.
Доработать Search engine можно, но инструмент очень уж специализированный. Переносить в него всё, что есть в SQLite — это годы. А просто добавить SQLite — это недели.
Теперь подумаем в обратную сторону. У вас теперь есть SQLite, в котором, на тот момент, реализован FTS3. Зачем вам держать Search engine? Затем, что Search engine уже отлично работает на всех платформах. Портирование поиска на SQLite малоприоритетно, его рационально отложить.
А уже через полгода Web SQL объявляют устаревшим, и у вас есть все основания полагать, что SQLite отлетит через пару лет. Но через пару лет отлетает сама Опера.
Доказать такой ход событий я не могу, но выглядит он логично.
Имеется ли смысл держаться за Search engine сейчас, когда в SQLite может быть включён отличный FTS5? Теоретически — можно произвести замеры производительности. Написать прослойку совместимости, нагенерировать случайных данных. Для поиска по истории замерить холодный и тёплый запуск, добавление документа во время загрузки страницы, удаление диапазона истории, префиксный и фразовый поиск, ранжирование первых N результатов, генерацию выдержки, память и размер на диске. Для M2 — импорт, ежедневные вставки и удаления, поиск, открытие больших папок, восстановление после принудительного завершения и размер. Каждый прогон нужен на Windows и Linux, на SSD и HDD. И тогда принимать решение.
К счастью, моя задача — восстановить браузер таким, каким он был, и всей этой ерундой мне можно не заниматься.
XXXIII.IV Забытая фича
Но вообще это не значит, что, имея такой продвинутый, пусть и довольно конкретный, инструмент, инженеры Opera не думали о его переиспользовании. Раскапывая код, я нашёл связанную фичу TWEAK_URL_SEARCH_ENGINE_CACHE.
Задумка простая: весь браузерный кеш — это файлы. Этих файлов — много, и они мелкие. Листинги каталогов на HDD — долгие. Приспособим Search engine для хранения индекса кеша; сами ресурсы, конечно, в нём хранить не стоит, но вот метаданные лягут туда идеально, если создать под них нужные структуры данных.
Сделано было довольно много, но фича так никогда и не была финализирована. Её флаг отключён во всех конфигурациях, а код содержит грубые ошибки и простые недоделки — его явно забросили. Почему?
Потому что нашлось решение проще. Уже имеющийся индексный файл dcache4.url научили хранить метаданные каждого ресурса, а в случае, если ресурс меньше 2 Кб, — то и сам ресурс. Ресурсы от 2 Кб до 16 Кб стали записываться в файлы-контейнеры, привязанные к доменам, ну а ресурсы большего размера так и остались файлами на диске, только структура каталогов была оптимизирована.
В результате маленький favicon, CSS-фрагмент или ответ сервера не требует:
- создания отдельного файла;
- открытия и закрытия file handle;
- отдельной записи каталога;
- расхода целого filesystem cluster ради нескольких сотен байтов;
- перечисления этого файла при восстановлении кеша.
Документация хранит историю замеров: ценой нескольких добавленных мегабайт индекса и немного большего расхода памяти, общая скорость чтения кеша выросла на 50%, а скорость записи — в десять раз.
Код фичи TWEAK_URL_SEARCH_ENGINE_CACHE оказался не нужен и забыт. Дорабатывать эту систему сейчас тем более не имеет смысла, и я её удалил.
XXXIV. Айсберг IndexedDB и судьба Web SQL
Всё это — только присказки, подводящие вас к реальной задаче столь же неумолимо, как айсберг к Титанику.
Стандарт объектного хранилища, рекомендованный Mozilla и Microsoft, был принят: IndexedDB. Это транзакционная объектная NoSQL key-value база данных, работающая асинхронно и реализующая разные фишки, удобные именно в сценариях веб-приложений. И вот его-то уже все реализовали по-своему. Ну, почти.
Microsoft воспользовалась своим проприетарным движком Extensible Storage Engine — это та же технология, что обеспечивает индексацию Windows Search и хранит каталог пользователей Active Directory. Реализовали IndexedDB они криво и не совсем полноценно, добавив к многочисленным грехам своего Internet Explorer ещё один.
Apple и, неожиданно, Mozilla использовали SQLite, прозрачно для разработчика транслируя NoSQL в SQL.
А вот в Google написали свой движок LevelDB, строго заточенный именно под NoSQL-операции и оттого более быстрый. Теперь он живёт во всех chromium-based браузерах.
Было бы забавно понаблюдать, что бы случилось после смерти Internet Explorer, выбери Google тот же путь, что Apple и Mozilla. Спойлер: прежнего цирка бы не случилось, ситуации разные.
А что же выбрать нам?
В 2026 году выбор NoSQL-хранилищ довольно велик. Давайте представим, что у нас нет очевидного и напрашивающегося решения, и пройдёмся по всему списку.
- Memcached. Решает не ту задачу, это распределённый кеш в памяти (допускает потерю и вытеснение данных), работающий как клиент-сервер. Его переделка обойдётся дорого.
- Redis. Также решение другого класса. Хоть и умеет работать постоянным хранилищем, его жизненный цикл совершенно не совпадает с профилем IndexedDB.
- LevelDB. Решение от Google прямо из Chrome — быстрое и надёжное. Но есть загвоздка: транзакции, индексы, ограничения уникальности, миграции, блобы — всё это не часть хранилища. Chromium реализует этот слой самостоятельно — значит, и нам пришлось бы.
- RocksDB. Технически пригоден, но его профиль — серверные нагрузки и значительные объёмы данных. Он принесёт сложную настройку, фоновые потоки, кеши и множество файлов ради возможностей, которые не будут использованы. Оверкилл.
- Berkeley DB. Подходит, хоть и тяжеловат. Но имеет неудобное лицензирование: либо коммерческая лицензия Oracle, либо GNU AGPL.
- LMDB. Хорошее, компактное встраиваемое B-tree-хранилище с ACID и MVCC. Но вся база отображается в адресное пространство памяти, что не соответствует идеологии Opera. Плюс всё ещё требует собственной реализации схем, внешних ключей, миграций и частичных уникальных индексов.
- Собственное решение, например поверх того же Search engine. Технически возможно, и было бы интересно, не будь у нас очереди из десятка других подсистем, требующих написания.
- SQLite. Уже интегрирован в код, даёт транзакции, savepoints, индексы, ограничения целостности и миграции. Лучше всего использует существующие механизмы Opera и переносит больше опасных инвариантов на проверенный движок.
SQLite вписывается в подход Opera, поэтому IndexedDB будет строиться поверх него.
А что Web SQL? Он есть, в полностью работоспособном виде, но никому не нужен. Я оставил его в движке, скрыв за пользовательской настройкой. К вопросу об удалении стоит возвращаться, только когда Presto будет полноценно поддерживать IndexedDB, WASM и OPFS.
XXXV. Что дальше?
Внезапно я осознал, что потратил на проект весь свой месячный отпуск. Ни капли сожаления, это было увлекательно. Но, скорее всего, мне теперь придётся замедлиться.
Тем не менее, я рассчитываю добавить в Opera IndexedDB, а в Dragonfly — инструменты для работы с ним. Эта работа уже начата, и горизонт виден.
Затем — без оглашения сроков — ECMAScript 2026, включая Unicode 17, актуальные RegExp, новые типы данных и весь Intl. Звучит сверхамбициозно, но без этого всё, что уже сделано, как будто теряет смысл.
Остальное — посмотрим.