The Engine We Lost: Digital Archaeology of Opera Presto
Новый IndexedDB и старая VEGA
Оглавление
Археология этой недели получается куда короче, чем она должна быть. У меня попросту не хватает сил свести воедино все заметки, которые я делаю по ходу работы. Признаюсь, я сильно перегружен.
Поэтому — как есть, возможно, я расширю какие-то места позже.
XXXVI. IndexedDB на месте
Дизайн подсистемы, который был проработан до мелочей в предыдущей части, воплотился в код. Порядок событий, время жизни транзакций, преобразование объектов JavaScript, работа с файлами, квоты, приватный режим, воркеры — всё это теперь есть — по крайней мере, проходит тесты. Как и было решено, IndexedDB работает на основе SQLite. Тут может возникнуть вопрос: а разве сам SQLite не поддерживает хотя бы часть из перечисленного выше? Транзакции, например, есть и там, и там.
Хотелось бы, но это так не работает. SQLite и IndexedDB соотносятся примерно так же, как файловая система и почтовый клиент. Клиент может хранить каждое письмо в отдельном файле, но сведения о переписке и непрочитанных сообщениях ему придётся учитывать самому. Вот и SQLite обеспечивает целостность данных, а браузер отвечает за правила, по которым эти данные существуют.
Самый простой пример — сортировка. Казалось бы, и цифровые, и алфавитные сортировки SQLite умеет, и даже разбирается в сортировках разнотипных данных.
Но у IndexedDB порядок свой: Number < Date < String < Binary < Array. А если этого мало — есть вложенные массивы, двоичные ключи, UTF-16-строки, бесконечности, канонизация -0, запрет NaN и специальные правила сравнения. Задача решается не слишком сложно, но демонстрирует разницу подходов.
XXXVI.I IndexedDB в отдельном потоке
Ядро Presto в основном однопоточное. JavaScript, DOM, события, документы и большая часть браузерной логики живут в главном потоке. Если выполнить там тяжёлый SQL-запрос, синхронизацию файла или восстановление журнала, вместе с базой остановится вся Opera. Разработчики уже столкнулись с этим при реализации WebSQL, и им пришлось написать патч для SQLite, позволяющий прерывать операции. Это даёт возможность делить тяжёлые запросы на части — приемлемое решение по соотношению усилий к результату, но и у него есть свои недостатки. Патч нужно аккуратно переносить при обновлении SQLite, он не гарантирует отзывчивость, он всё ещё потребляет ресурсы основного потока, а для контроля нужно писать какую-то машину состояний. Тем не менее, пойти этим путём было возможно.
Другой вариант — сделать самую простую реализацию, внутри главного потока, и потом перенести её на многопоточные рельсы. Такой вариант был бы на порядок быстрее и проще сейчас, но при последующем переносе пришлось бы заново проектировать отмену, закрытие, владение памятью и почти все состояния транзакций — и поверьте, я бы предпочёл к пройденному не возвращаться.
Поэтому для IndexedDB был введён отдельный поток:
Главный поток: JavaScript → проверка и подготовка запроса
                                  │
                            очередь заданий
                                  ↓
Поток IndexedDB: операции с базой → SQLite → диск
                                  │
                            очередь завершений
                                  ↓
Главный поток: восстановление объектов → события для страницы
Подготовка запроса осталась в главном потоке. Обращение к свойству сохраняемого объекта может вызвать написанную страницей функцию; запрос дополнительного места — показать диалог. Здесь же проверяются права, планируются транзакции и подготавливается двоичное представление данных. Объект IDB_Job формируется на куче, и указатель на него помещается в очередь заданий.
Память внутри процесса общая, поэтому передаётся только указатель: поток IndexedDB забирает задание из очереди, исполняет его и, записав служебные данные, тем же образом возвращает ссылку через другую очередь. Для больших и многошаговых ответов поддерживается передача частями — приёмник в главном потоке уже сам собирает цепочку частичных реплаев в целое.
Потоки реализованы вполне стандартно: CreateThread() в Windows и PosixThread::CreateThread() в Linux, и новая абстракция OpWorkerThread легла по соседству с уже имеющимся OpPseudoThread (про него нам ещё придётся вспомнить). Эту абстракцию будет куда легче заменить на межпроцессную, если мы до этого доберёмся.
XXXVI.II Финализируем транзакцию
Спецификация IndexedDB местами выглядит безумно. Вот простой пример: представьте, что страница прочитала из IndexedDB большой Blob, сохранила ссылку на него, а затем удалила исходную запись. Данные должны остаться доступными, пока жив объект JavaScript. Более того, можно удалить всё хранилище объектов, закрыть соединение, удалить именованную базу и тут же создать новую с тем же именем — старый Blob всё ещё обязан читаться и не имеет права внезапно привязаться к новой базе. Ещё веселее: Blob может стать видимым для JavaScript до физической фиксации транзакции. Если она потом откатится, уже выданный объект всё равно не должен превратиться в пустышку.
Весело? Что-то я не вижу улыбок на ваших лицах.
И такого тут навалом, и иногда было совершенно непонятно, как это вообще сделать. Но перед глазами были реализации из Firefox и Chromium — им приходилось решать те же проблемы. И даже больше: я мог начать сразу с IndexedDB 3.0, и не поддерживать предыдущие спецификации.
Конечно, получилось абсолютно точно не лучше, чем в Firefox, и не быстрее Chrome. За их движками стоят годы профилирования, огромные команды и многопроцессная архитектура, которой у Presto пока нет. Chrome использует LevelDB и выиграет на многих типичных key-value нагрузках. Firefox умеет обслуживать базы параллельно и располагает полноценной фоновой инфраструктурой QuotaManager. А я радуюсь тому, что моя реализация, по крайней мере, не тормозит.
Делая факт-чек, я обнаружил, что Chrome также переводит IndexedDB на SQLite. Мне как-то нечего об этом сказать, но факт интересный.
И напоследок — инспектор IndexedDB был добавлен в Dragonfly. Это потребовало расширения протокола scope, но я вынужден оставить рассказ об этом за рамками этой недели.
XXXVII. Копаем VEGA
А вот тут я виноват сам. Я захотел починить один крохотный баг, одну отошедшую половицу — а закончил переделкой целого этажа.
Зайду, как обычно, издалека.
Страница состоит из текста, картинок, кривых, заливок, полупрозрачных слоёв. Примерно из того же состоит интерфейс браузера: адресная строка, вкладки, меню. В Opera их рисование сходится в одной библиотеке. Quick, отвечающий за интерфейс, и код отображения документов обращаются к общему рисовальщику, реализованному поверх VEGA. Исправление на этом уровне может одновременно затронуть и страницу, и окружающее её окно.
Сама VEGA умеет рассчитывать геометрию, превращать её в пиксели, накладывать изображения и применять эффекты. Для этого у неё есть несколько бэкендов:
Страница, SVG, canvas, интерфейс Opera
                  │
                 VEGA
                  ├─ программный растеризатор → пиксели в оперативной памяти
                  │
                  └─ 3D-бэкенд → общий интерфейс графического устройства
                                      ├─ Direct3D 10.1
                                      └─ OpenGL
В исходниках сохранился также двумерный аппаратный бэкенд через DirectFB. В настольных сборках он никогда не включается, и, вероятно, был нужен для устройств где других вариантов не предусмотрено.
Подсистема инициализируется при старте программы, и в рантайме переключаться между бэкендами нельзя.
Судя по интерфейсам, инженеры рассчитывали переносить библиотеку между устройствами, сохраняя общий код рисования и меняя его нижний, платформенный слой. В тогдашних планах Opera были компьютеры, телефоны и телевизоры — об этом, например, говорил ведущий разработчик графики Тим Юханссон в анонсе WebGL 2011 года. Такая архитектура позволяла приспособиться и к возможностям очередной платформы, и к её ограничениям.
XXXVII.I Проблема масштаба
Я использую несколько мониторов с разной плотностью пикселей и разным масштабом. Старая Opera на них выглядела хуже, чем могла бы, но с этим можно мириться. На дробном масштабе — 125%, 150% и тому подобных — возникали ещё и неприятности на границах окна. Координаты могли расходиться буквально на пиксель, и щелчок по краю браузера иногда срабатывал как щелчок снаружи.
Windows умеет помогать приложениям, которые ничего не знают о высокой плотности пикселей: они рисуют окно в привычном разрешении, а система увеличивает готовую картинку. Размер получается подходящий, но текст и мелкие детали могут размываться.
Чтобы получить чёткое изображение, программа должна сама рисовать под нужное разрешение. Для этого она объявляет себя DPI-aware, и Windows перестаёт масштабировать её окно. Включить такую пометку в манифесте легко; дальше приложению придётся обработать масштаб самостоятельно. У Opera с её собственным интерфейсом эта работа почти целиком ложится на графическую подсистему. Подробнее об этом механизме у Microsoft.
К счастью, в коде нашёлся TWEAK_DISPLAY_PIXEL_SCALE_RENDERING. За ним скрываются преобразователь координат, масштабируемый рисовальщик и возможность узнать масштаб поверхности окна. Значительную часть нужной работы инженеры уже сделали, но код снова оказался не полностью готовым. И я их понимаю, масштабирование — это сложно.
Для понимания возьмём кнопку шириной в сто логических пикселей. При масштабе 150% она должна занять сто пятьдесят пикселей поверхности. Код кнопки по-прежнему просит нарисовать прямоугольник шириной сто; преобразование выполняет рисовальщик. Координаты мыши, пришедшие от системы, проходят обратное преобразование, чтобы проверка попадания работала в тех же единицах.
Дальше возникает обычная для большого проекта неприятность: почти везде всё сходится, а в одном месте что-нибудь забыли. Размеры окна, обрезка изображения, меню, перетаскивание, курсор — каждый участник должен пользоваться правильными координатами. Иначе меню открывается со смещением или клик попадает не туда, где нарисована кнопка.
Кроме того, полутора пикселей в растровом буфере не бывает. Для поверхности границу приходится округлять наружу, чтобы не оставить полоску у края. Сохранённое положение окна нужно пересчитывать так, чтобы оно не уползало и не росло после нескольких преобразований туда и обратно. На 200% многие такие ошибки незаметны, а на 125% вылезают сразу.
XXXVII.II Буквы, мониторы и прокрутка
В Windows режим DPI-aware устанавливается до создания первого окна. Настройку для этого приходится читать ещё до инициализации обычных коллекций настроек Opera. Нужные системные функции загружаются с проверкой доступности, чтобы на старых версиях Windows хоть как-то работать.
Затем каждое окно получает свой масштаб и передаёт его графическому слою. При переносе между мониторами Windows присылает уведомление и рекомендует новые размеры. Тут важен порядок: сначала переключить масштаб рисовальщика, потом менять геометрию и перерисовывать содержимое. Даже если логический размер остался прежним, физических пикселей могло стать больше.
Обойти масштабирование шрифтов тоже не получится — у текста своя жизнь и свои правила. Чтобы разложить текст по строкам, браузеру нужно знать размеры букв. Если просто подменить шрифт увеличенным, можно заодно получить другие переносы строк и несовпадение текста с выделением, поэтому приходится делать всё правильно. Честно говоря, этот кусок кода я пока прибил гвоздями — с оперовским рендерером шрифтов ещё придётся разобраться получше.
С прокруткой пока тоже не вышло, как хотелось. Старый код передвигал уже нарисованный прямоугольник и дорисовывал освободившуюся полоску — хорошая оптимизация на повторном рисовании. Но при масштабировании физические пиксели перемещались на расстояние, рассчитанное в логических. Поэтому при масштабе, отличном от 100%, этот путь пока отключён, и прокручиваемая область перерисовывается полностью.
Под Linux общий код тот же, а масштаб берётся из настроек X11-сеанса, включая Xft.dpi. Пока это одно значение, выбранное при запуске. Динамического переключения между мониторами с разными масштабами, как в Windows, здесь ещё нет.
В целом, масштабирование выглядит рабочим, но всё ещё с огрехами. Даже если отбросить проблемы кода, останутся ещё скины — графика в них растровая, при растягивании выглядит плохо.
Чувствую, что возвращаться сюда придётся ещё не раз.
XXXVII.III Возвращение аппаратного ускорения
Вот тут-то я и поддался искушению посмотреть, как реализовано аппаратное ускорение — и завяз с ним надолго.
Рабочий код тут соседствовал с недоделанным, отладочными обёртками и забагованными счётчиками. Механизм «чёрных списков» оборудования то ли сломан, то ли просто не готов: он никогда не разрешал включать ускорение интерфейса через OpenGL под Windows, ссылаясь на внутренние бенчмарки. WebGL есть, но как экспериментальная фича с неясной степенью реализации.
Пока что это самый «невылизанный» код из того, что я нашёл, что неудивительно — аппаратное ускорение было самой новой подсистемой Opera, у неё не было времени «настояться». Но архитектура у неё интересная.
Аппаратный бэкенд VEGA превращает операции в вершины, треугольники и текстуры; программы-шейдеры вычисляют результат их рисования. Совместимые операции собираются в пакеты. Например, прямоугольники с одной текстурой и одинаковыми настройками можно нарисовать вместе, сэкономив на подготовке устройства и отдельных вызовах. Но объединять операции нужно с оглядкой на порядок: два перекрывающихся полупрозрачных объекта при перестановке дадут другую картинку. Иногда требуется сменить поверхность, применить фильтр или обновить текстуру, уже участвующую в очереди. Накопленную работу приходится отправлять на исполнение раньше, и пакеты получаются меньше — и рендер всё это учитывает.
Часть подготовки выполняется на процессоре; для некоторых операций он рассчитывает маски. Шрифты тоже обслуживаются разными путями: Windows-бэкенд Direct3D пользуется DirectWrite и Direct2D. В итоге за простым с виду вызовом рисования стоит конвейер со своим учётом ресурсов, очередями и синхронизацией.
А иногда всё нужно отправить обратно. Страница может запросить байты уже нарисованного canvas: придётся дождаться видеокарты и прочитать результат в оперативную память. Если постоянно чередовать рисование с таким чтением, обмен данными способен съесть выигрыш от ускорения.
Программный растеризатор VEGA в этом случае находится в выгодном положении — пиксели уже лежат в оперативной памяти. Вообще, он довольно хорошо устроен: обрабатывает изображение построчно и экономно расходует память. Есть и специальные SIMD-оптимизации, хотя их переключатель выключен — с этим ещё предстоит разобраться.
Работает ли то, что есть?
Да. Технически — картинка выводится, ускорение для WebGL применяется. Но система довольно сырая, производительность скачет от сценария к сценарию, и в большинстве случаев обычный программный интерфейс оказывается быстрее. Многих фич нет, а то, что есть — устарело. Реализация далека от готовности, но сам дизайн подсистемы вполне зрелый.
Я начал с кажущейся мелочи: списков совместимости. Грубо говоря, это реестр записей, сообщающих браузеру, какие сценарии аппаратного ускорения допустимы на текущем оборудовании. Такие механизмы есть и у Chrome, и у Firefox; в Opera также попытались их реализовать, и сырость тут видна невооружённым взглядом — в правилах буквально встречаются опечатки.
Учитывая то, что список этот устарел на полтора десятилетия, проку от него сейчас нет. Итог — сам механизм «чёрных списков» оставлен, но больше не пытается обновиться с давно отключённых серверов Opera, а пользователю разрешено вовсе игнорировать эти правила.
Затем я восстановил работу бэкендов OpenGL и Direct3D на том уровне, на каком она была заложена изначально. К счастью, эти API практически не имеют «сроков годности», и в современных Windows без проблем будут работать версии DirectX, начиная с 9, а Opera использовала DX 10. Про OpenGL и говорить нечего — даже код тридцатилетней давности запустится с современными драйверами с очень высокой вероятностью.
Сейчас, за неимением времени, мне придётся опустить технические подробности. Надеюсь рассказать об этом позже, когда вернусь сюда с доработками. Сейчас — просто короткий список того, что было сделано:
- OpenGL полностью разблокирован на Windows.
- Можно включать и выключать ускорение отдельно как для самого браузера, так и только для WebGL.
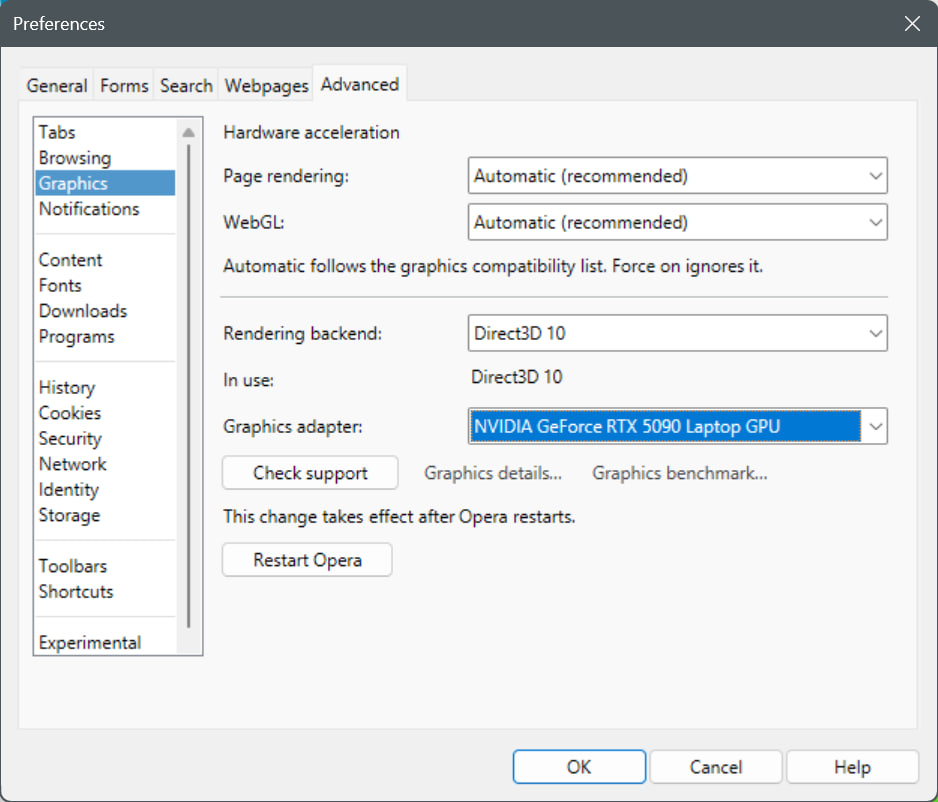
- Теперь пользователь может сам переключать бэкенды отрисовки между программным, OpenGL и Direct3D 10 (для Windows).
- Для Direct3D можно выбирать видеоадаптер. Сейчас, когда интегрированные адаптеры стоят в каждом первом компьютере, это вполне актуально.
- Также для Direct3D поддерживается программная эмуляция через WARP.
- Внутренняя страница
opera:gpuдоработана и показывает все известные сведения, связанные с аппаратным ускорением. - WebGL 1.0 восстановлен до минимально работоспособного состояния.
И о WebGL как раз хочется сказать пару слов.
XXXVII.IV Доработки WebGL
Нет, подумайте секунду: аппаратно ускоренная трёхмерная графика в браузере. А что завтра? Браузеры будут работать с USB?..
…Так, стоп, подождите.
Первая версия WebGL вышла в 2011 году и опиралась на OpenGL ES 2.0 — относительно компактный набор возможностей, подходивший в том числе для мобильных устройств. В 2017 году появился WebGL 2.0 на основе OpenGL ES 3.0. Через этот API страница передаёт геометрию, текстуры и программы-шейдеры. Браузер проверяет запросы и направляет их в графическую подсистему.
В Opera 12 фича живёт под именем experimental-webgl. Некоторые библиотеки до сих пор это поддерживают, но реализация Opera всё равно оказалась неработоспособной. Глобально она не сломана, но не работала из-за суммы мелочей, как ошибок, так и расхождений со спецификацией. Это странно, учитывая, что стандарт, который разрабатывался, в том числе и в Opera, появился чуть раньше этой версии кода. Почему так — мы уже не узнаем.
Основная работа была связана с компилятором шейдеров. Он тут собственный и занимается тем, что принимает на вход описание шейдеров WebGL в формате GLSL ES, и, в зависимости от выбранного бэкенда, переводит их в GLSL (для OpenGL) или HLSL (для Direct3D). Здесь пришлось поправить проверки шейдеров и их перевод, операции с матрицами, векторами, текстурами и т.д. Разбор большого шейдера тут мог переполнить стек компилятора из-за рекурсивного обхода дерева выражений программы; во избежание этого рекурсия была заменена на итеративный обход.
Сложнее оказалось обойти схожую проблему для компилятора шейдеров Microsoft — это то, что находится в d3dcompiler_xx.dll. Он принимает переданный ему текст HLSL и компилирует байткод для Direct3D. По умолчанию компилятору был доступен стек размером в один мегабайт памяти, чего ему не хватало при разборе длинных выражений. Внутрь чужой библиотеки с исправлением не влезешь — пришлось запускать компилятор в новом системном потоке с резервом стека в 16 МиБ. Но и этого стека может оказаться недостаточно, поэтому сложность выражений проверяется, и потенциально тяжёлый шейдер отбрасывается.
Попутно добавились расширения для дополнительных форматов текстур, сохранения настроек вершин и многократного рисования одной геометрии с разными параметрами. Последнее удобно, например, когда сцене нужно много одинаковых объектов: их можно отправить на рисование одним вызовом.
Работа проверялась набором тестов Khronos для всех платформ и бэкендов, как с настоящим аппаратным ускорением на видеокартах NVIDIA/AMD/Intel, так и на программных рендерерах WARP/llvmpipe.
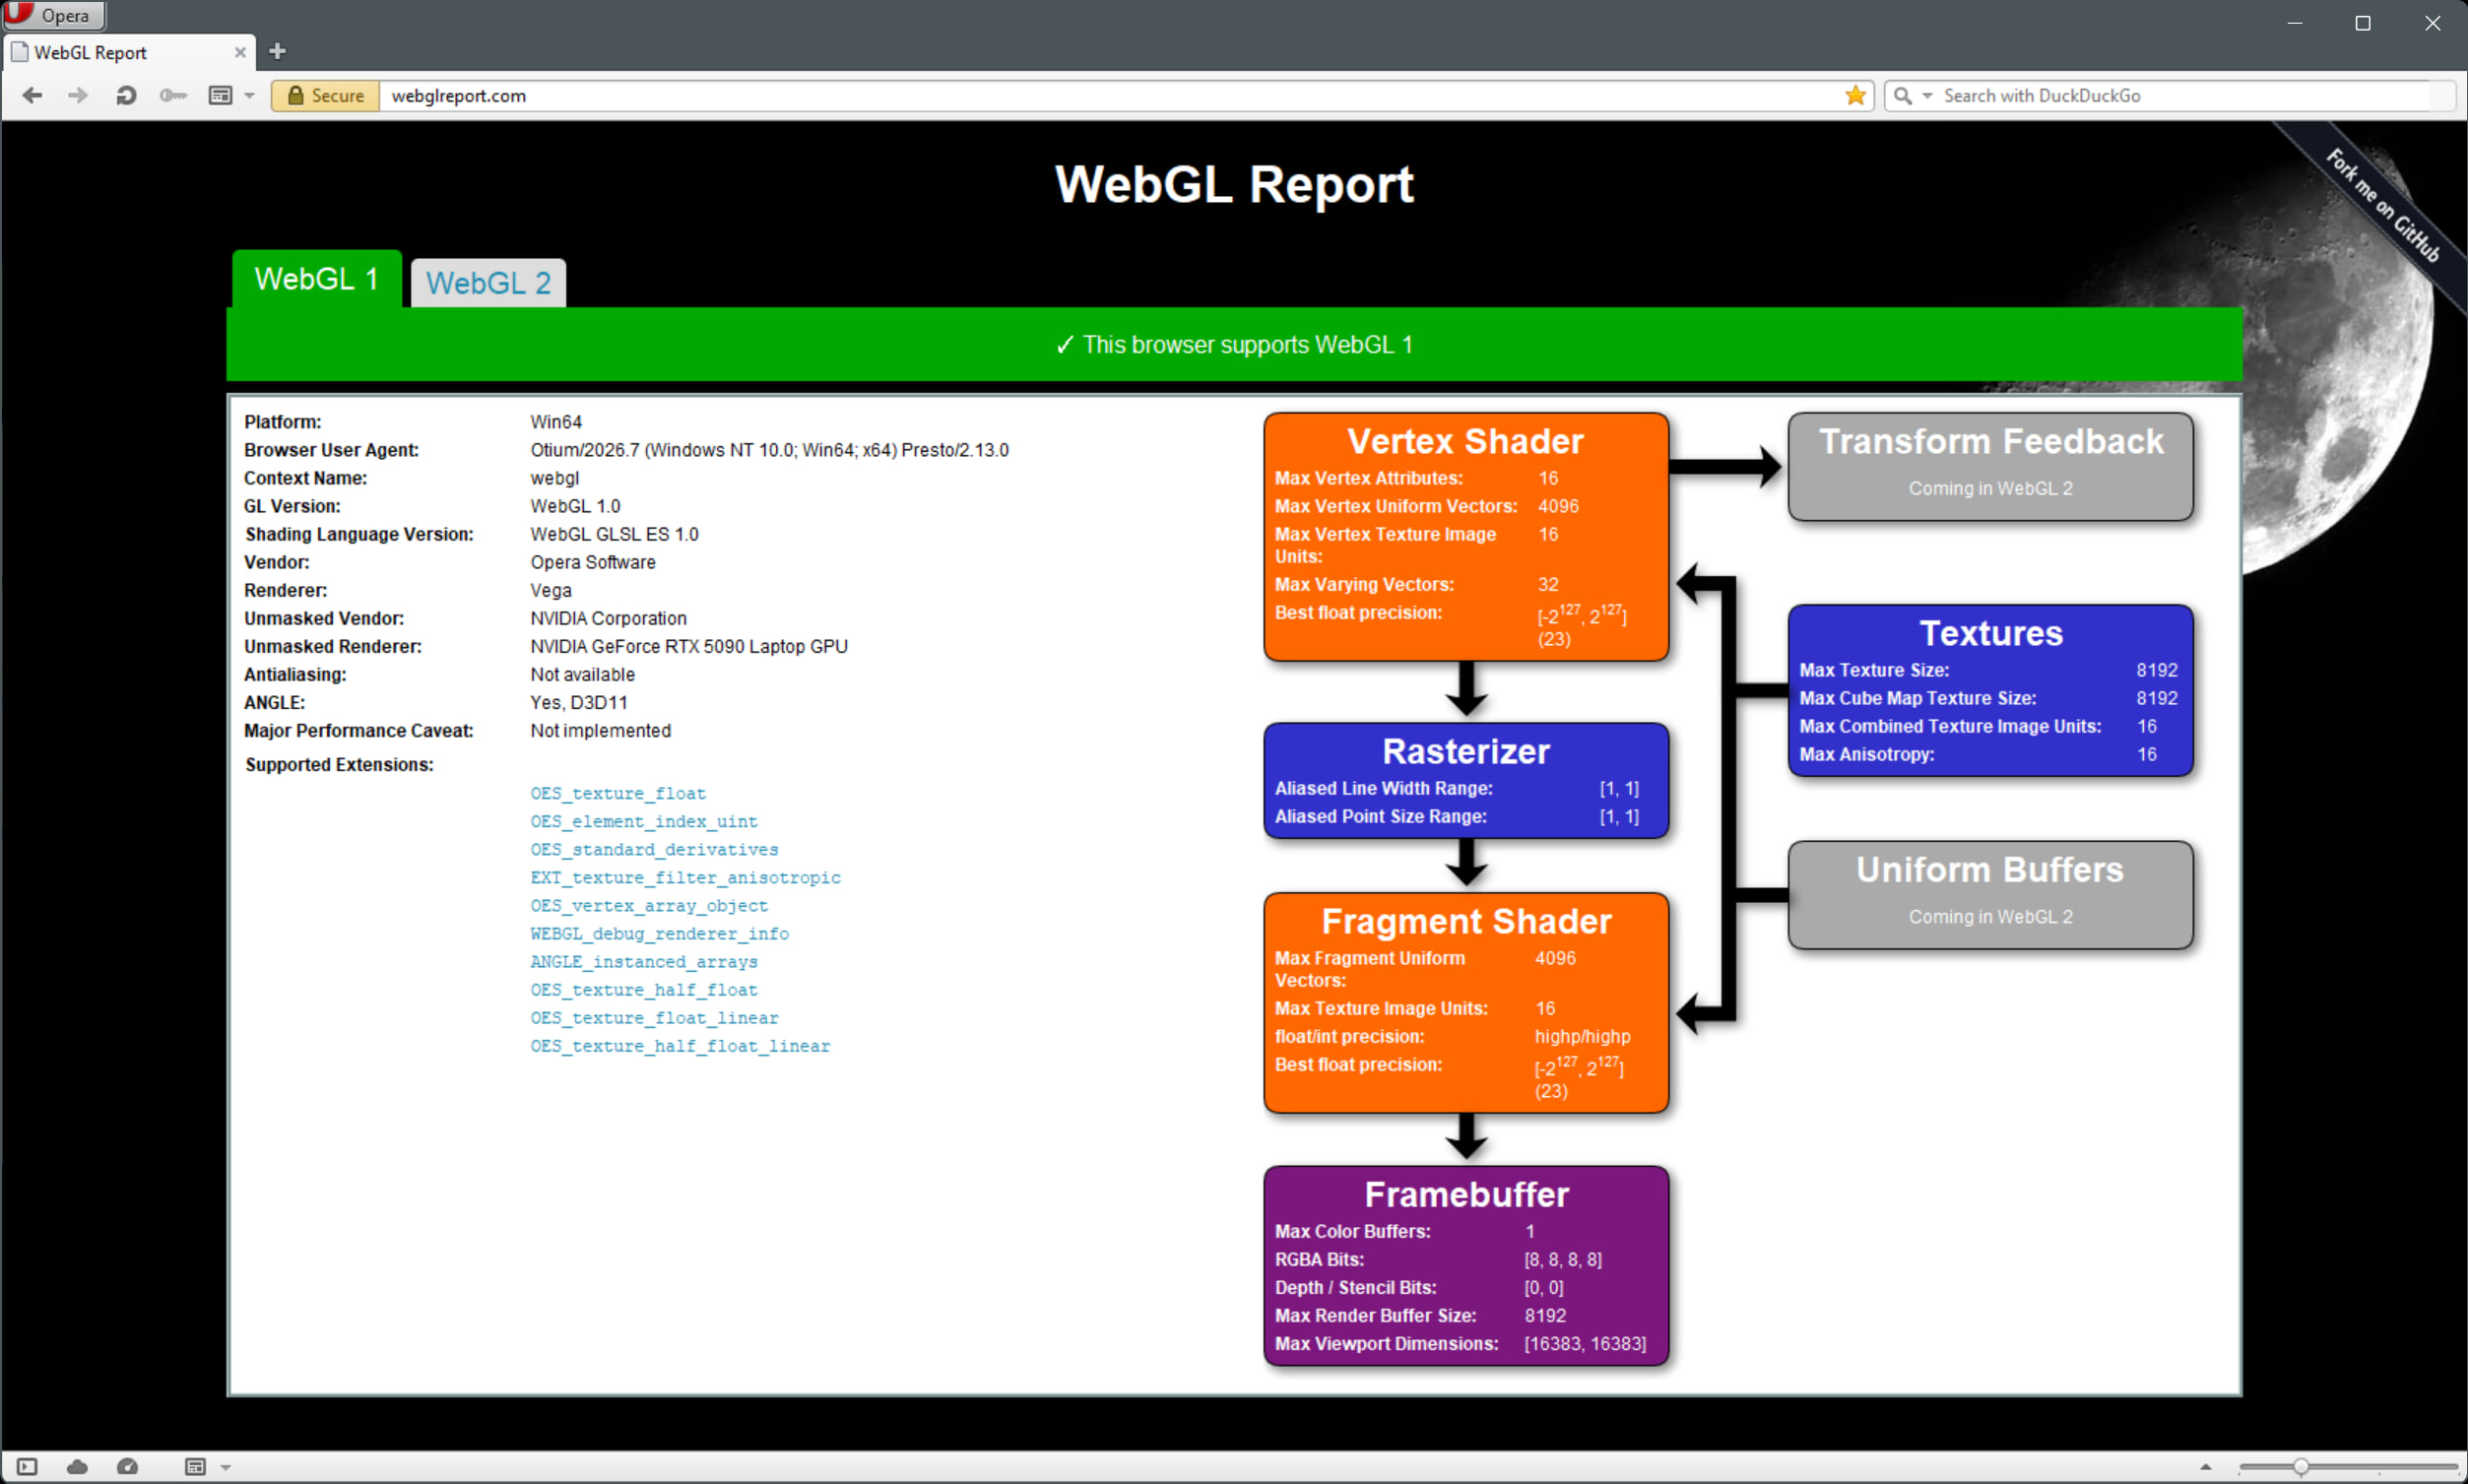
В результате у нас есть относительно рабочий WebGL 1.0 с несколькими документированными лакунами, которые, надеюсь, не составит труда закрыть. Можно рассчитывать, что WebGL 2.0 однажды тоже будет добавлен, а вот более современный WebGPU — это совершенно другое API, которое делать нужно с нуля.
XXXVIII. Что дальше?
Упомянутые доработки — далеко не всё, что было финализировано за неделю. Добавлен Streams API, и Fetch теперь может работать в потоковом режиме. Появились Subresource Integrity и HTML template elements. В реализацию Identity добавлен полноценный редактор, и пользователи сами могут настраивать идентификацию браузера, как глобально, так и для каждого сайта отдельно.
Но самое сложное — честно говоря нереально сложное — всё ещё близится. Черновая реализация ECMAScript 2026 дописана и тестируется. Я собираюсь полностью сосредоточиться только на этом.
Хорошая новость: браузер уже проходит 72 254 из 81 178 тестов редакции ES2026. Плохая новость — один прогон test262 в debug-сборке Opera занимает ~30 часов. Релизные сборки работают быстрее, но для отлова ошибок крутить приходится именно дебажную — и это откровенно изматывает.